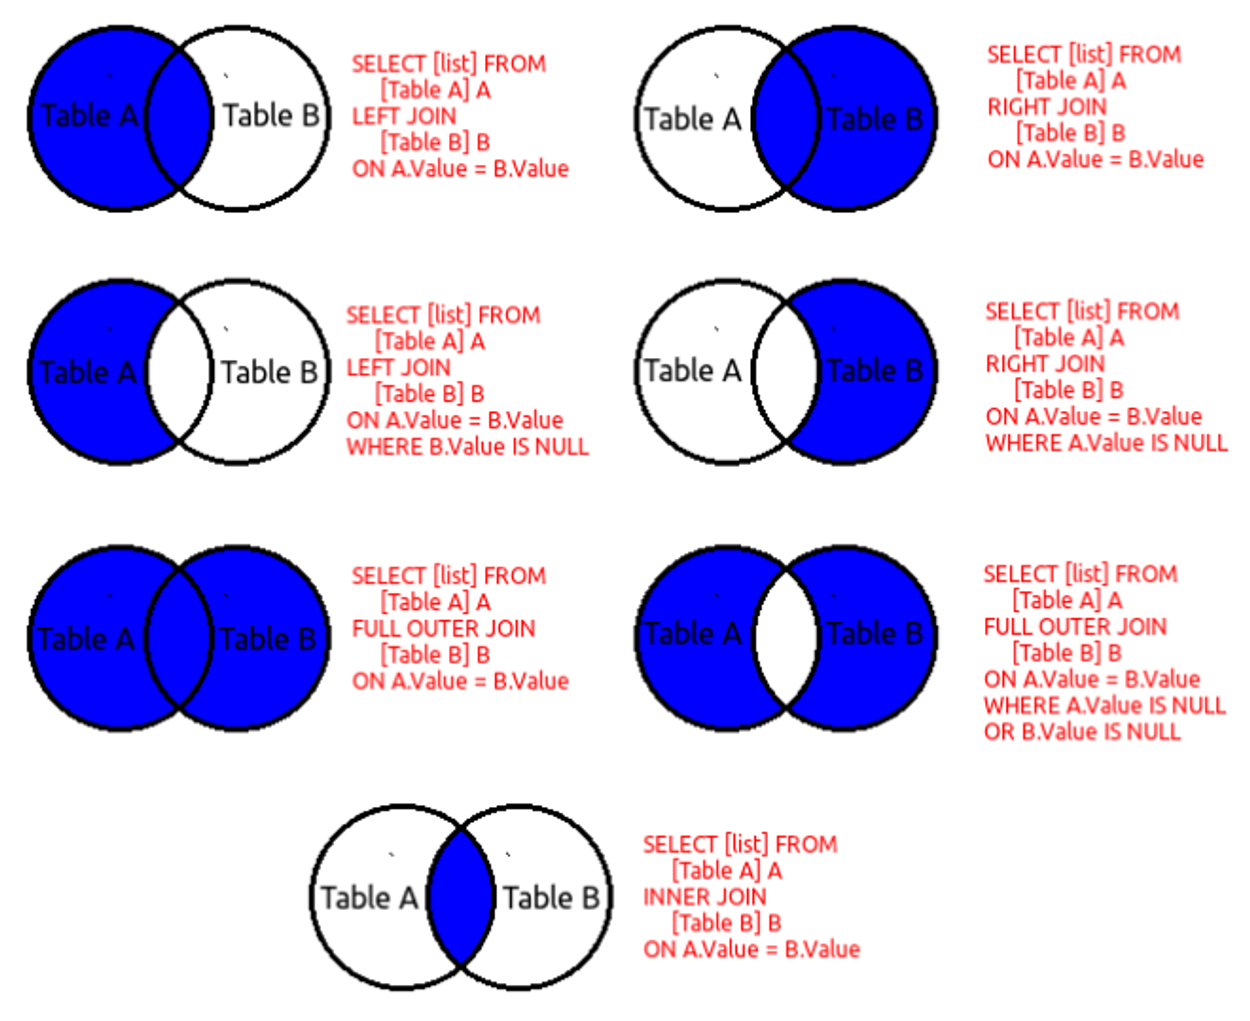
2. ORACLE vs PostgreSQL
| 속성 | ORACLE | PostgreSQL |
|---|---|---|
| 소개 | RDBMS | 오픈소스 RDBMS 🚩 객체 지향 DBMS(Postgres)로 개발됨, SQL과 같은 표준으로 점차 향상 |
| RDBMS인가? | O | O 🚩 객체지향확장 (사용자 정의 유형/ 상속 및 상속), hstore 모듈을 사용한 키값 처리 |
| 점유순위 | 1위 | 4위 |
| 공식 문서 | 링크 | 링크 |
| 서비스 제공 | Oracle | PostgreSQL Global Development Group |
| 서비스 시작 | 1980 | 1989 |
| 라이센스 | 기업용 / 무료버전 있음 | 오픈소스(BSD) |
| 클라우드 기반 전용 | X | X |
| 구현언어 | C, C++ | C |
| 서버 운영 체제 | AIX, HP-UX, Linux, OS X, Solaris, Windows, z/OS | FreeBSD, HP-UX, Linux, NetBSD, OpenBSD, OS X, Solaris, Unix, Windows |
| 데이터 스키마 | O | O |
| XML 지원 | O | O |
| 🚩 보조인덱스 | O | O |
| SQL | O(전매 표준) | O(많은 확장의 표준) |
| API 및 기타 액세스 방법 | JDBC, ODBC, ODP.NET, Oracle Call Interface (OCI) | ADO.NET, JDBC, native C library, ODBC, streaming API for large objects |
| 지원 언어 | C, C#, C++, Clojure, Cobol, Delphi, Eiffel, Erlang, Fortran, Groovy, Haskell, Java, JavaScript, Lisp, Objective C, OCaml, Perl, PHP, Python, R, Ruby, Scala, Tcl, Visual Basic | .Net, C, C++, Delphi, Java info, JavaScript, Node.js, Perl, PHP, Python, Tcl |
| 서버 사이드 스크립트 | PL/SQL (자바에서 가능한 저장 프로시저 포함) | 사용자 정의 함수 (PL/pgSQL 또는 Perl, Python, TCL 등과 같은 공통 언어로 구현) |
| 트리거 | O | O |
| 🚩 파티셔닝 방법 | Sharding = horizontal partitioning | partitioning by range, list and (since PostgreSQL 11) by hash |
| 🚩 복제 방법 | Multi-source replication (다중 소스 복제) Source-replica replication (원본 복제) | Source-replica replication (원본 복제) 🚩 타사 확장을 사용하여 가능한 기타 방법 |
| 🚩 맵리듀스 | X | X |
| 일관성 개념 | Immediate Consistency (즉각적) | Immediate Consistency (즉각적) |
| 외래키 | O | O |
| 트랜잭션 개념 | ACID (정보 격리 수준 매개 변수화 가능) | ACID |
| 🚩 동시성 | O | O |
| 🚩 지속성 | O | O |
| 🚩 메모리 내 기능 | O 🚩 버전 12c에서 새로운 옵션 ‘Oracle Database In-Memory’ 도입 | X |
| 🚩 사용자 개념 | SQL 표준에 따라 세분화된 액세스 권한 | SQL 표준에 따라 세분화된 액세스 권한 |
1. 보조인덱스
💡 Secondary indexes
2. 파티셔닝 방법
💡 하나의 테이블을 특정 분할 기준(ex. 여, 남, 날짜)에 따라 수평 분할(레코드로 분할)하는 것
오라클 파티션 테이블
오라클 파티션 기능은
STANDARD버전일 경우 불가(PERSONAL,ENTERPRISE EDITION만 가능)
- (1) Range : 범위 단위로 나누어진 테이블(ex. 날짜)
- (2) List : 특정 컬럼 값을 기준으로 파티셔닝을 수행
- (3) Hash : 데이터를 해시 알고리즘에 의해 무작위로 분산시켜 삽입
포스트그레스큐엘 파티션 테이블
10 버전 이전에는 상속을 이용한 구현으로 상속 하는 테이블과 받는 테이블 사이에
trigger를 걸어서 서로를 연결하는 번거로운 방법을 사용해야 했지만, 10버전 이후parent-child형태로 단순하게 사용이 가능해짐
- (1) 파티션 PARENT 생성
PARTITION BY RANGE(id): id 범위를 기준으로 한 RANGE Partitionpartition_bound_spec 설정 예 : FOR VALUES FROM (1) to (1000)
PARTITION BY LIST(class): class column을 기준으로 한 LIST Partitionpartition_bound_spec 설정 예 : FOR VALUES IN (‘G’, ‘V’)
PARTITION BY HASH(id): id column을 기준으로 한 HASH Partitionpartition_bound_spec 설정 예 : FOR VALUES WITH (MODULUS 10, REMAINDER 5)
(2) CHILD 테이블 생성
- (3) 데이터 삽입
- (4) 파티션 삭제
💡 [오라클]> [포스트그레스큐엘[1][2](공식)(상속-트리거 방식)]
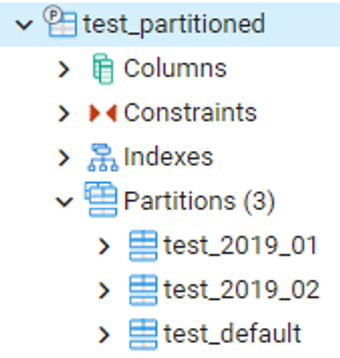
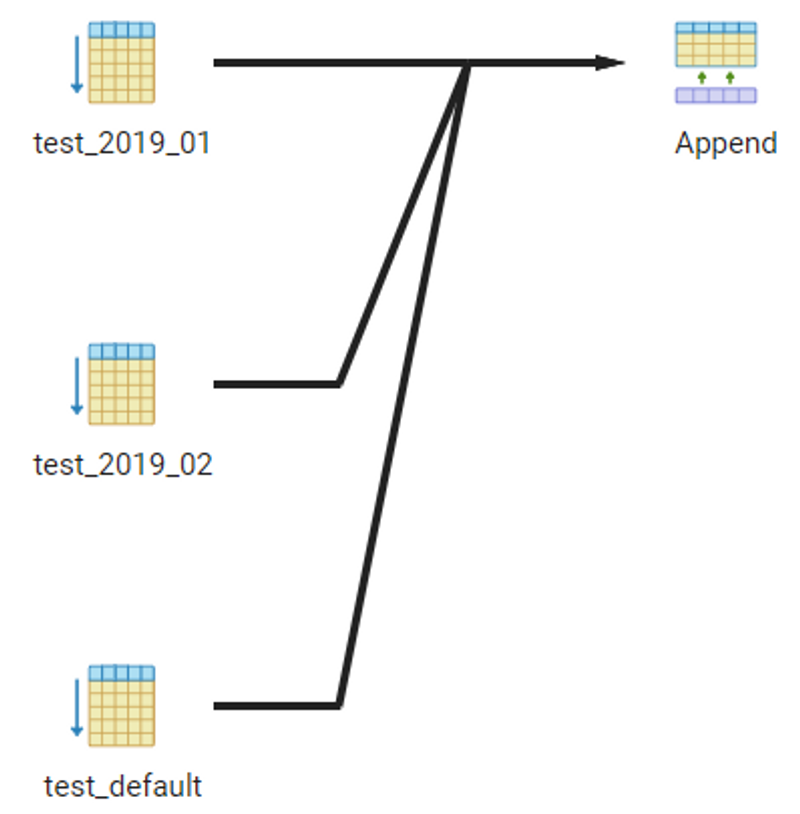
3. 복제 방법
💡 여러 노드에 데이터를 중복 저장하는 방법
4. 맵리듀스
💡 구글에서 대용량 데이터 처리를 분산 병렬 컴퓨팅에서 처리하기 위한 목적으로 제작하여 2004년 발표한 소프트웨어 프레임워크.
맵(Map)+리듀스(Reduce)로 이루어져 있으며,
Input(데이터 입력)
→Splitting(데이터를 쪼개 HDFS에 저장)
→Mapping
→Shuffling(맵 함수의 결과 취합을 위해 리듀스 함수로 데이터 전달)
→Reducing(모든 값을 합쳐 원하는 값 추출)
→Final Result과 같은 과정을 거친다.
[출처]
5. 동시성
💡 동시 데이터 조작 지원
6. 지속성
💡 지속적인 데이터 생성 지원
7. 메모리 내 기능
💡 일부 또는 모든 구조를 메모리에만 보관할 수 있는 옵션이 있는지
8. 사용자 개념
💡 접근 제어
3. 설치
🔰 PostgreSQ\ data 디렉토리 내부에 설치되는 파일
-
base: pg_default 테이블스페이스 : 데이터베이스 별로 디렉토리 생성하여 데이터 저장한다. -
global: pg_global 테이블스페이스 : Cluster 레벨에서 관리하는 데이터 저장한다. -
pg_hba.conf: PostgreSQL에 접속을 관리하는 파일이다. -
pg_log : log파일 생성 디렉토리이다. -
pg_tblspc: 사용자 테이블스페이스 : 테이블스페이스 디렉토리 symbolic link를 생성한다. -
postgresql.auto.conf: ALTER SYSTEM 명령어로 파라미터 수정시 기록한다. -
postgresql.conf: 주요 설정파일이다.
4. 환경 변수 설정
- 제어판 > 시스템 > 고급 시스템 설정 > 환경 변수 > 시스템변수 > path편집
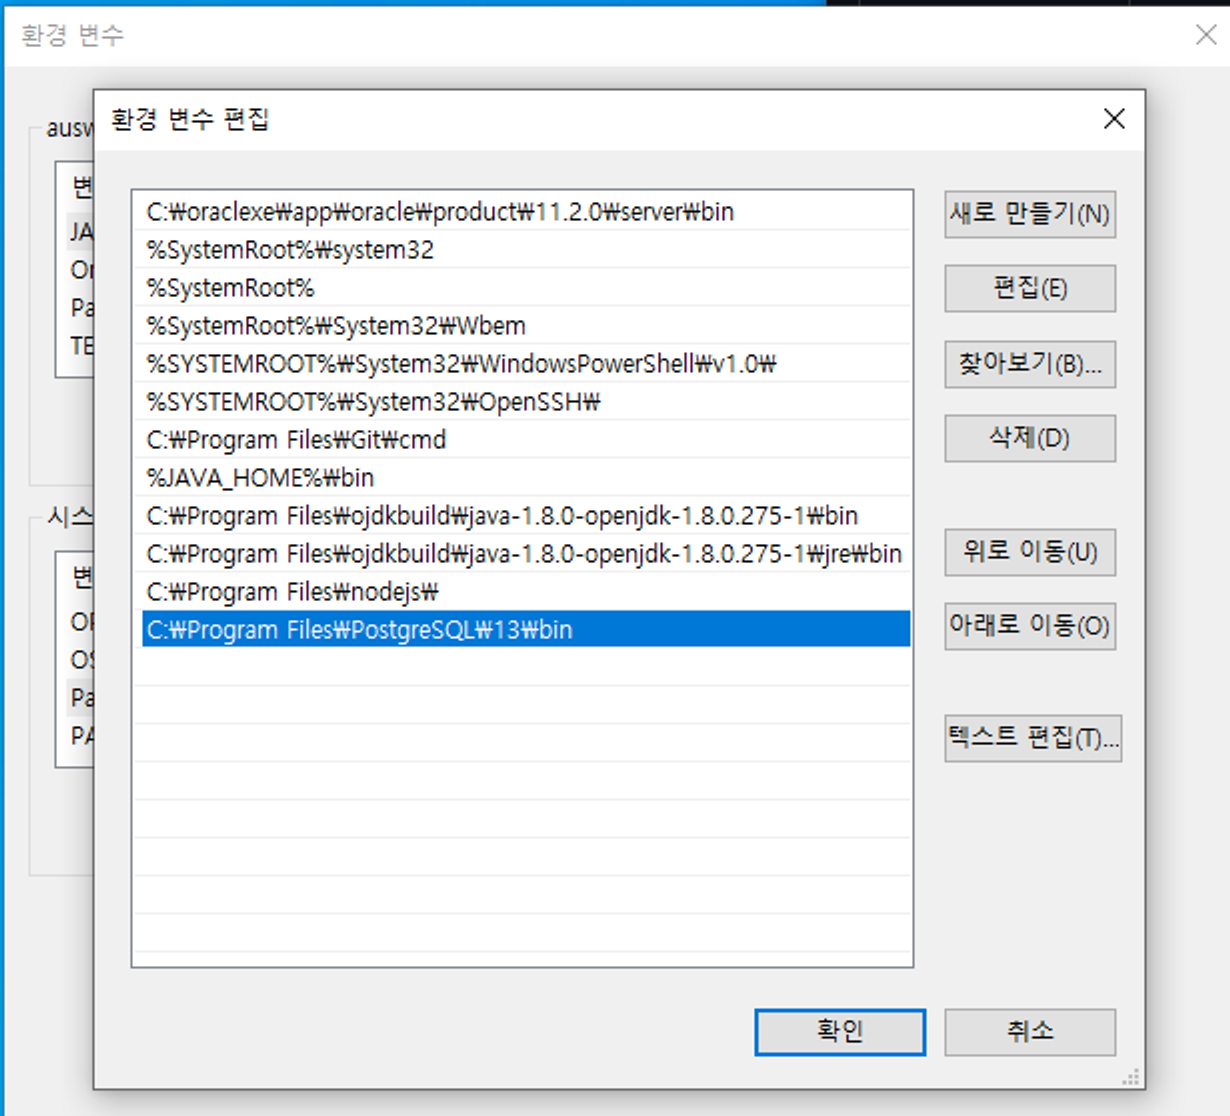
5. 접속
- SQL Shell(psql)
- 명령 프롬프트
1
2
  $ psql -U (postgre[name]) // 접속
  $ psql --version // 버전 조회
- pgAdmin4(전용 GUI 툴)
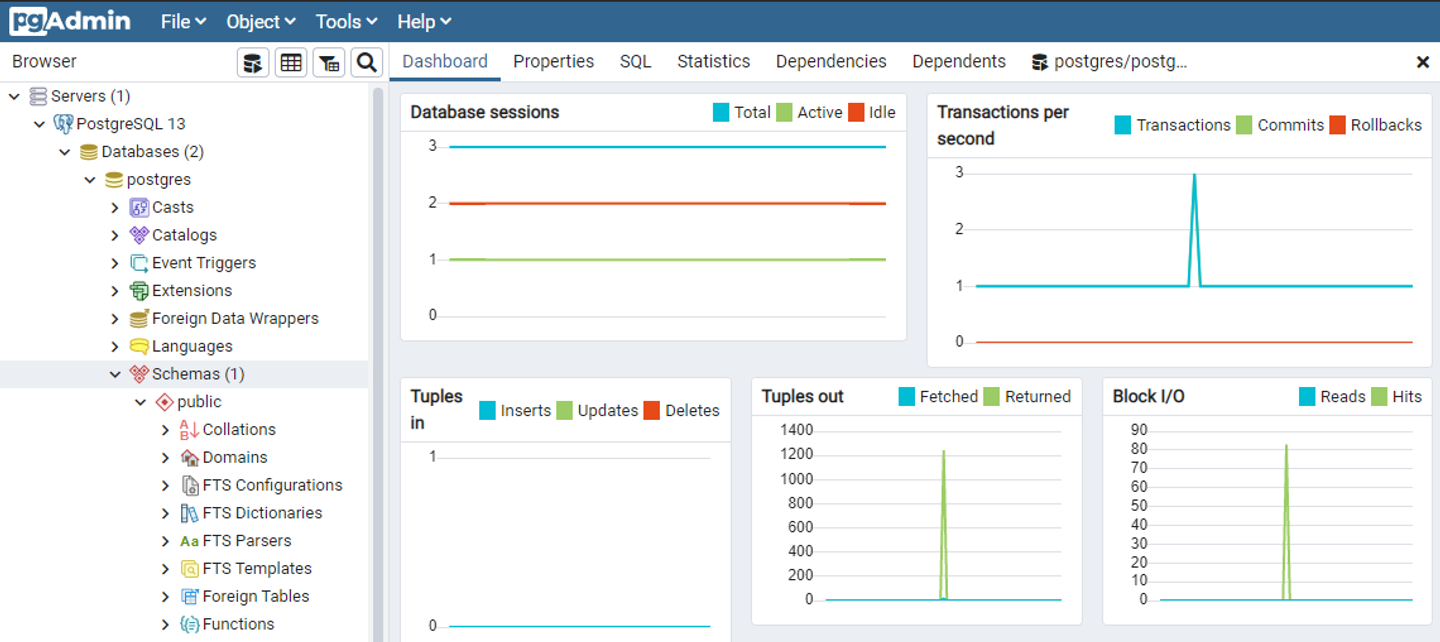
6. CRUD
| 명령어 | 설명 | 예시코드 |
|---|---|---|
| \q | psql 종료 | - |
| \l | 데이터베이스 조회 | - |
| \c | 입력한 데이터베이스로 이동 | \c [dbName] |
| \e | 외부편집기 사용 | - |
| \dt | 현재 데이터베이스 테이블 확인 | - |
| \db | 테이블 스페이스 확인 | - |
1) CREATE | CREATE TABLE [tb_name] ([컬럼명][자료형],...);
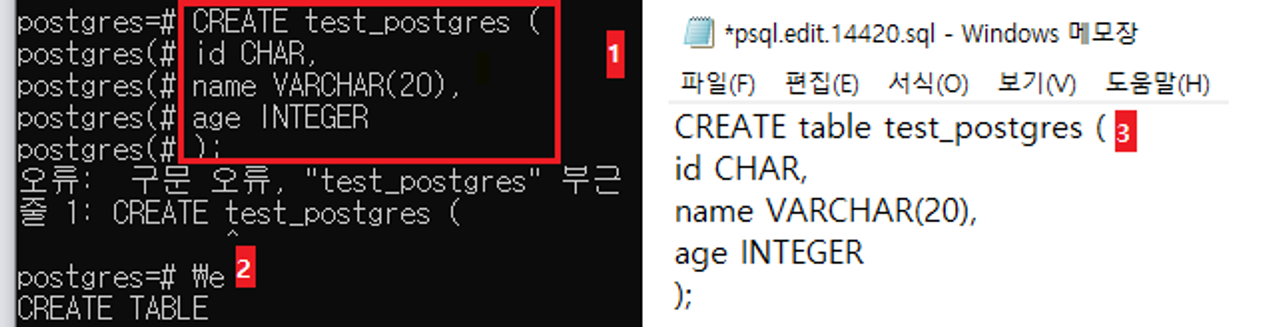
- SQL shell에 차례대로 입력 *구문 오류가 있을 시, 오류 문구가 출력됨
- \e 명령어 입력
- 외부 편집기로 쿼리 수정 후 저장
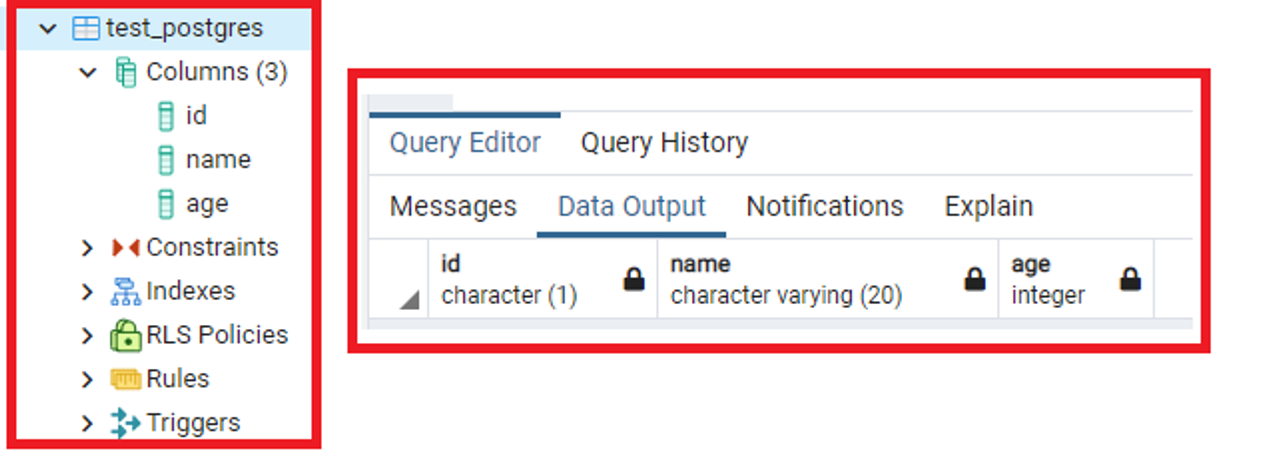
1
2
3
-- 기존 테이블 복사 후 생성(칼럼, 레코드 데이터 복사됨)
CREATE TABLE [new_table_name] AS
	SELECT * FROM [old_table_name]
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
-- 예시
SELECT * FROM AddressBook;
// 결과
id |  name  |                             attributes
----+--------+---------------------------------------------------------------------
  1 | 김가가 | "age"=>"38", "email"=>"111@aaa.co.kr", "telephone"=>"010-1111-1111"
  2 | 김나나 | "age"=>"29", "email"=>"222@bbb.co.kr", "telephone"=>"N/A"
(2개 행)

CREATE TABLE book AS SELECT * FROM AddressBook;
SELECT * FROM book;
// 결과
id |  name  |                             attributes
----+--------+---------------------------------------------------------------------
  1 | 김가가 | "age"=>"38", "email"=>"111@aaa.co.kr", "telephone"=>"010-1111-1111"
  2 | 김나나 | "age"=>"29", "email"=>"222@bbb.co.kr", "telephone"=>"N/A"
(2개 행)
2) SELECT | SELECT * FROM "[schema_name]".[tb_name];
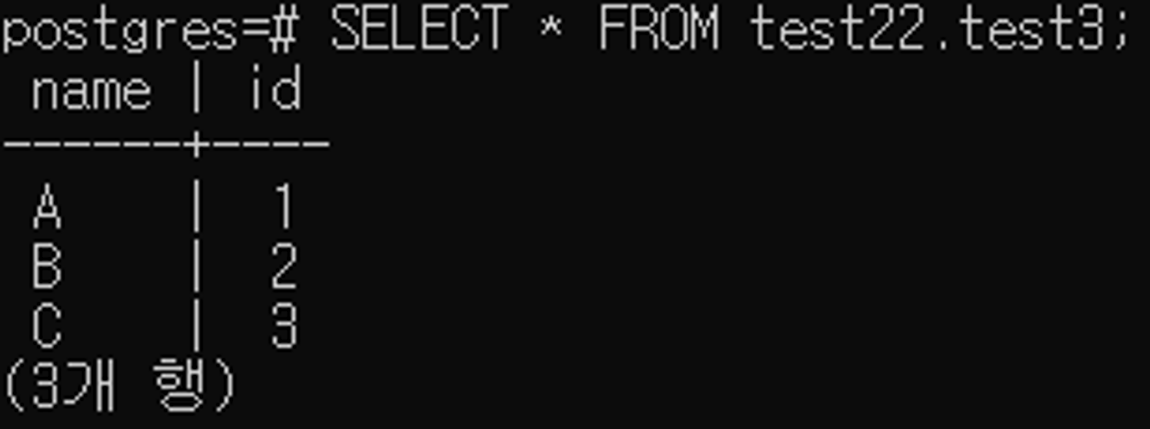
3) INSERT & UPDATE
1
2
3
4
5
6
INSERT INTO [tb_name] ([column]) VALUES ([values]);
-- 여러 개 추가
INSERT INTO book VALUES (1, 2, 3), (4, 5, 6), ..., (7, 8, 9);

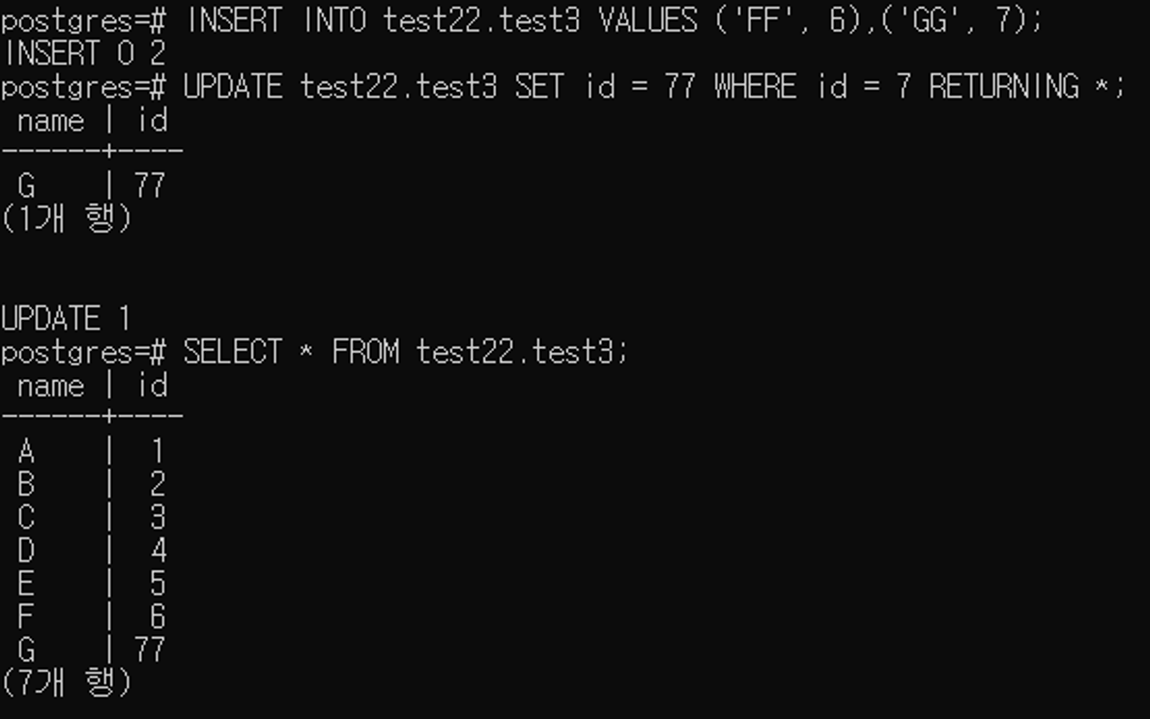
UPDATE [tb_name] SET [column] = [values] WHERE [condition] [RETURNING *];
-- RETURNING * : 수정한 내용 바로 조회
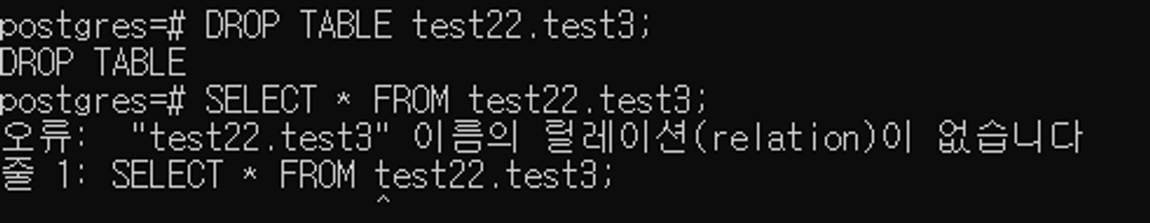
4) DELETE | DROP TABLE [tb_name]
7. 자료형
| 데이터 타입 | 별칭 | 설명 | 용량 |
|---|---|---|---|
| bigint | int8 | 부호 있는 8바이트 정수형 | |
| bigserial | serial8 | 자동 증가 8바이트 정수형 | |
| bit [ (n) ] | 고정 길이 비트 문자열 | ||
| bit varying [ (n) ] | varbit | 가변 길이 비트 문자열 | |
| boolean | bool | 논리 불린형 (참/거짓) | |
| box | 평면 위 직각사각형 | ||
| bytea | 이진자료 (“바이트 배열”) | ||
| character [ (n) ] | char [ (n) ] | 고정 길이 문자열 | |
| character varying [ (n) ] | varchar [ (n) ] | 가변 결이 문자열 | |
| cidr | IPv4 또는 IPv6 네트워크 주소 | ||
| circle | 평면 위 원 | ||
| date | 달력 날짜 (년, 월, 일) | 4 | |
| double precision | float8 | 2배 정밀 부동 소수형 (8 바이트) | 8 |
| inet | IPv4 또 IPv6 호스트 주소 | ||
| integer | int, int4, numeric(n)[숫자 자리수 제한] | 부호 있는 4바이트 정수형 | 4 |
| interval [ fields ] [ (p) ] | 시간 간격 | ||
| line | 평면 위 무한 직선 | ||
| lseg | 평면 위 선분 | ||
| macaddr | MAC (매체 접근 제어) 주소 | ||
| money | 화폐형 | ||
| numeric [ (p, s) ] | decimal [ (p, s) ] | 정밀도 선택 가능한 숫자형 | 가변적 |
| path | 평면 위 기하학적 경로 | ||
| point | 평면 위 기하학적 위치 | ||
| polygon | 평면 위 기하학적 닫힌 경로 | ||
| real | float4 | 부동소수형 (4 바이트) | 4 |
| serial | serial4 | 자동 증가 4바이트 정수형 | 4 |
| smallint | int2 | 부호있는 2바이트 정수형 | |
| text | 가변 길이 문자열 | ||
| time [ (p) ] [ without time zone ] | 시각 (지역시간대 없음) | 8 | |
| time [ (p) ] with time zone | timetz | 지역시간대 포함한 시각 | 12 |
| timestamp [ (p) ] [ without time zone ] | 날짜와 시각 지역시간대 없음) | 8 | |
| timestamp [ (p) ] with time zone | timestamptz | 지역시간대를 포함한 날짜와 시각(GMT+9) | 8 |
| tsquery | 텍스트 검색 쿼리 | ||
| tsvector | 텍스트 검색 문서 | ||
| txid_snapshot | 사용자 수준 트랜잭션 ID 스냅샷 | ||
| uuid | 범용 고유 식별자 | ||
| xml | XML 자료 |
timestamp [ (p) ] with time zone
1
2
3
4
5
-- 시간대 정보 출력
SHOW TIMEZONE;

-- 시간 설정
SET TIMEZONE = 'America/Los_Angeles';
그 외 자료형
🔰 배열형 : Array[]
1
2
3
4
5
6
7
8
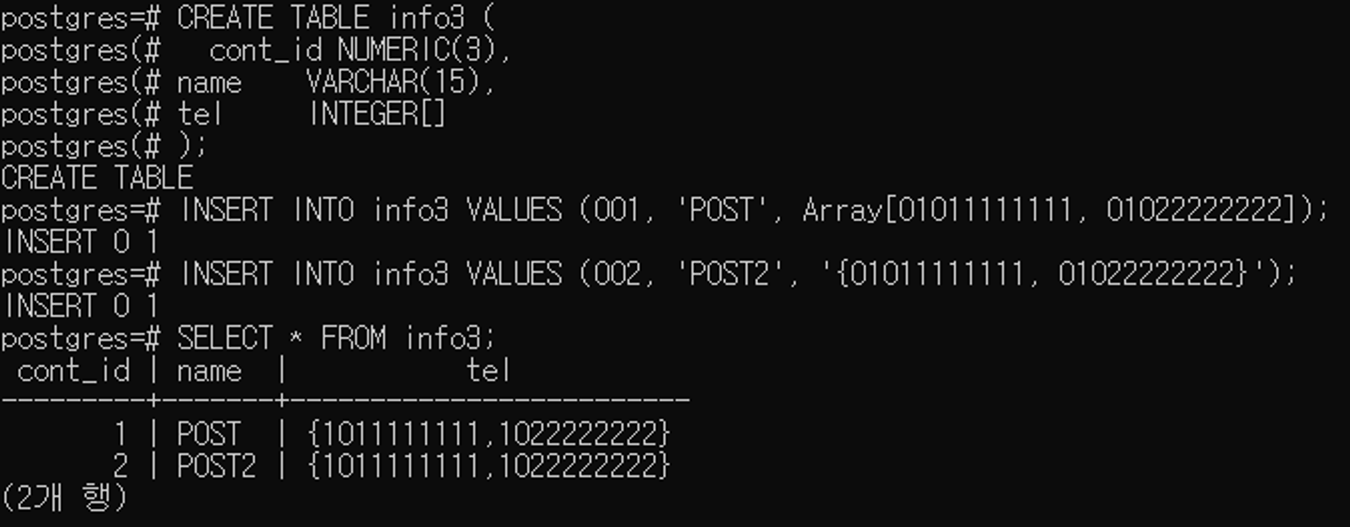
CREATE TABLE info3 (
  cont_id NUMERIC(3),
  name    VARCHAR(15),
  tel     INTEGER[]
);

INSERT INTO info3 VALUES (001, 'POST', Array[01011111111, 01022222222]);
INSERT INTO info3 VALUES (002, 'POST2', '{01011111111, 01022222222}');
🔰 JSON형 : JOSN / JSONB
1
2
3
4
5
SELECT '{"bar": "baz",           "balanc   e": 7.77, "active":false}'::json;
// "{""bar"": ""baz"",           ""balanc   e"": 7.77, ""active"":false}"

SELECT '{"bar": "baz",            "balanc   e": 7.77, "active":false}'::jsonB;
// "{""bar"": ""baz"", ""active"": false, ""balanc   e"": 7.77}"
JSON은 들어온 그대로 값을 저장한다. 그런데 JSONB는 그대로 저장하지 않는다. 문자열 사이의 공백을 제거하고, KEY 순서를 보장하지 않는다
1
2
3
4
5
6
7
8
9
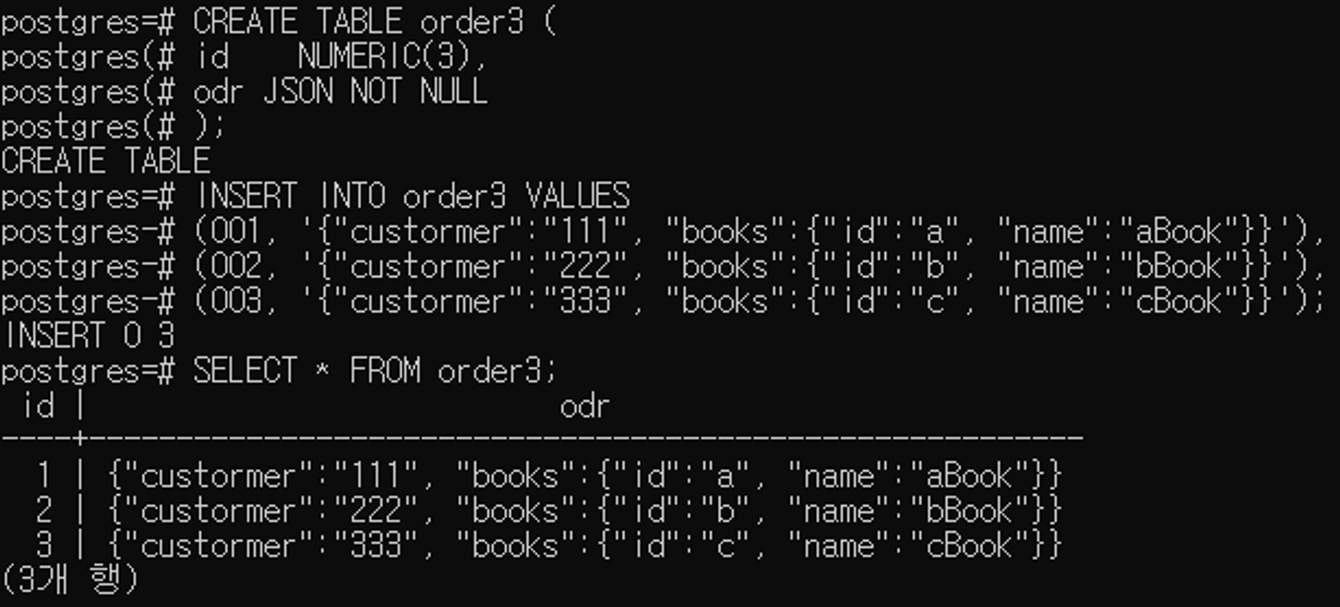
CREATE TABLE order3 (
  id    NUMERIC(3),
  odr   JSON NOT NULL
);

INSERT INTO order3 VALUES
  (001, '{"custormer":"111", "books":{"id":"a", "name":"aBook"}}'),
  (002, '{"custormer":"222", "books":{"id":"b", "name":"bBook"}}'),
  (003, '{"custormer":"333", "books":{"id":"c", "name":"cBook"}}');
8. 활용
1) 연산자 및 함수
| PostgreSQL | ORACLE |
|---|---|
| SELECT 1; | SELECT 1 FROM dual; |
| NEXTVAL.[sequence_name] | [sequence_name].NEXTVAL |
| CAST(표현식 AS 바꿀 데이터 타입) | TO_CHAR, TO_NUMBER 등 형변환 함수 |
| COALESCE(<매개변수1>, <매개변수2>,...)매개변수2>매개변수1> | NVL(컬럼, 치환할 값) |
| NULLIF(<매개변수1>, <매개변수2>,...)매개변수2>매개변수1> | NULLIF(<매개변수1>, <매개변수2>,...)매개변수2>매개변수1> |
| now(), CURRENT_DATE 등 날짜, 시간 함수 | SYSDATE, SYSTIMESTAMP |
| CASE columns1 when val1 then result1 … else default END | DECODE(column1, val1, result1, …, default) |
| WITH RECURSIVE | CONNECT BY |
| TEXT(데이터 타입) | CLOB |
1. SELECT 1;
인라인 뷰
FROM 절에 사용하는 서브 쿼리를 인라인 뷰라고 함. 인라인 뷰를 사용할 때는 별칭을 붙여줘야 함.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
SELECT *
FROM (
  SELECT '{
    "guid": "9c36adc1-7fb5-4d5b-83b4-90356a46061a",
    "name": "Angela Barton",
    "is_active": true,
    "company": "Magnafone",
    "address": "178 Howard Place, Gulf, Washington, 702",
    "registered": "2009-11-07T08:53:22 +08:00",
    "latitude": 19.793713,
    "longitude": 86.513373,
    "tags": [ "enim", "aliquip", "qui" ]
    }'::json
) AS test_table;

// 결과
{
  "guid": "9c36adc1-7fb5-4d5b-83b4-90356a46061a",
  "name": "Angela Barton",
  "is_active": true,
  "company": "Magnafone",
  "address": "178 Howard Place, Gulf, Washington, 702",
  "registered": "2009-11-07T08:53:22 +08:00",
  "latitude": 19.793713,
  "longitude": 86.513373,
  "tags": [ "enim", "aliquip", "qui" ]
}
// 결과(SHELL)
json
---------------------------------------------------------
{                                                       +
  "guid": "9c36adc1-7fb5-4d5b-83b4-90356a46061a",       +
  "name": "Angela Barton",                              +
  "is_active": true,                                    +
  "company": "Magnafone",                               +
  "address": "178 Howard Place, Gulf, Washington, 702", +
  "registered": "2009-11-07T08:53:22 +08:00",           +
  "latitude": 19.793713,                                +
  "longitude": 86.513373,                               +
  "tags": [ "enim", "aliquip", "qui" ]                  +
}
(1개 행)

SELECT *
FROM (
  SELECT '{
      "guid": "9c36adc1-7fb5-4d5b-83b4-90356a46061a",
      "name": "Angela Barton",
      "is_active": true,
      "company": "Magnafone",
      "address": "178 Howard Place, Gulf, Washington, 702",
      "registered": "2009-11-07T08:53:22 +08:00",
      "latitude": 19.793713,
      "longitude": 86.513373,
      "tags": [ "enim", "aliquip", "qui" ]
    }'::json
);

// 결과
ERROR: 오류:  FROM 절 내의 subquery 에는 반드시 alias 를 가져야만 합니다
LINE 2: FROM (
             ^
HINT:  예, FROM (SELECT ...) [AS] foo.
단일행 서브쿼리
1
2
3
SELECT address
  FROM test_table
WHERE phone = (SELECT phone FROM p_table WEHRE name = 'test_name');
2. CAST(표현식 AS 바꿀 데이터 타입)
1
2
3
4
5
6
7
8
9
10
SELECT CAST('3000' AS INTEGER); // 3000

SELECT CAST('2020-08-11' AS TEXT), CAST('2020-08-11' AS DATE);
// 결과
text    |    date
------------+------------
 2020-08-11 | 2020-08-11
(1개 행)

SELECT '00:15:00'::TIME; // 00:15:00
3. COALESCE(<매개변수1>, <매개변수2>,...)
💡 오라클과의 차이점
- oracle : NVL(hire_date, SYSDATE) - 타입 불일치 시 묵시적 형변환 발생
- postgresql : COALESCE(hire_date, SYSDATE) - 컬럼타입 불일치 시 오류(상수는 OK)
4. NULLIF(<매개변수1>, <매개변수2>,...)
💡 <매개변수1> = <매개변수2> : NULL 반환매개변수2>매개변수1>
<매개변수1> != <매개변수2> : <매개변수1>반환 ```jsx SELECT NULLIF(20, 20); // NULL SELECT NULLIF(22, 23); // 22 ``` 매개변수1>매개변수2>매개변수1>
5. now(), CURRENT_DATE 등 날짜, 시간 함수
| 함수 | 설명 | 예시 |
|---|---|---|
| CURRENT_DATE | 현재 날짜 정보 반환 | SELECT CURRNET_DATE; |
| CURRENT_TIME | 현재 시간+시간대 정보 반환 | SELECT CURRENT_TIME(2); |
| CURRENT_TIMESTAMP | 현재 날짜 시간+시간대 정보 반환 | SELECT CURRENT_TIMESTAMP(2); |
| LOCALTIME | 시간 정보 반환 | SELECT LOCALTIME(2); |
| LOCALTIMESTAMP | 현재 날짜 및 시간 정보 반환 | SELECT LOCALTIMESTMAP; |
| age(<TIMESTAMP) | 현재 날짜 - | SELECT age(timestamp ‘2020-03-01’); |
| EXTRACT | 날짜 및 시간 데이터 타입에서 특정 정보만 추출 | SELECT EXTRACT (MONTH FROM TIMESTAMP ‘2020-09-20’); // 9월 |
| date_part() | EXTRACT와 유사 필드값을 문자열로 받음 | SELECT date_part(‘month’, now()); // 3월 |
| date_trunc() | 필요없는 날짜정보 제거 | SELECT date_trunc(‘month’, now()); // “2021-03-01 00:00:00+09” // (동작시점 : 2021-03-04) |
EXTRACT 필드 값
CENTURY 세기 QUARTER 분기 YEAR 연도 MONTH 월 DAY 일 HOUR 시간 MINUTE 분 SECOND 초 ISODOW 요일숫자(월(1) ~ 일(7)) DOW 요일숫자(일(0) ~ 토(6)) TIMEZONE 시간대
6. WITH RECURSIVE
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
-- 포스트그레스큐엘
with recursive 뷰명 as(
    초기 SQL
    union all(or union)
    반복할 SQL(+반복을 멈출 where절 포함)
)select * from 뷰명;

with recursive VIEWNAME as(
    select 1 as num
    union all
    select num+1 from VIEWNAME where num < 10
)select * from VIEWNAME;

-- 오라클
SELECT [컬럼]...
	FROM [테이블]
WHERE [조건]
	START WITH [최상위 조건]
CONNECT BY [NOCYCLE][PRIOR 계층형 구조 조건];

SELECT
	DEPT_NAME,
	DEP_CD,
	PARENT_CD,
	LEVEL
FROM DEP
	START WITH PARENT_CD IS NULL --최상위노드 설정,
CONNECT BY PRIOR DEP_CD = PARENT_CD;--부모노드와 자식노드 연결
7. TEXT(데이터 타입)
💡 CLOB 이란?
- CUBRID의 매뉴얼에는 아래와 같이 나와 있다. 간단하게 설명하면, 사이즈가 큰 데이터를 외부 파일로 저장하기 위한 데이터 타입이다.
- 문자열 데이터를 DB 외부에 저장하기 위한 타입이다.
- CLOB 데이터의 최대 길이는 외부 저장소에서 생성 가능한 파일 크기이다.
- CLOB 타입은 SQL 문에서 문자열 타입으로 입출력 값을 표현한다. 즉, CHAR(n), VARCHAR(n), NCHAR(n), NCHAR VARYING(n) 타입과 호환된다. 단, 명시적 > 타입 변환만 허용되며, 데이터 길이가 서로 다른 경우에는 최대 길이가 작은 타입에 맞추어 절삭(truncate)된다.
- CLOB 타입 값을 문자열 값으로 변환하는 경우, 변환된 데이터는 최대 1GB를 넘을 수 없다. 반대로 문자열을 CLOB 타입으로 변환하는 경우, 변환된 > 데이터는 CLOB 저장소에서 제공하는 최대 파일 크기를 넘을 수 없다.
그 외 연산자 및 함수의 사본
| 연산자/함수 | 설명 | 예시 | 예상결과 |
|---|---|---|---|
| array_append() | - 배열 뒤에 원소 추가 - 1 || ARRAY[2, 3] = {1, 2, 3} | array_append(ARRAY[1, 2], 3) | 배열 |
| array_prepend() | 배열 앞에 원소 추가 | array_prepend(1, ARRAY[2, 3]) | 배열 |
| array_remove() | 배열 속 특정 원소 삭제 | array_remove(배열, 원소) | 배열 |
| array_replace() | 배열 속 특정 원소를 다른 원소로 대체 | array_replace(배열, 원소1, 원소2) | 배열 |
| array_cat() | 두 배열 병합 | array_cat(배열1, 배열2) | 배열 |
| <@ 또는 @> | 포함관계 | ARRAY[1, 2, 3] @> ARRAY[1, 3] | boolean,NULL |
| 연산자/함수 | 설명 | 예시 | 예상결과 |
|---|---|---|---|
| 🚩 - > | - JSON 오브젝트에서 키 값으로 밸류 값 불러오기 - JSON 배열에서 인덱스로 JSON 오브젝트 불러오기 | - '{"a":"a1", "b":"b1", "c":"c1"}' :: json - > 'a'- '[{"a":"a1"}, {"b": "b1"}, {"c":"c1"}]' :: json - > 1 | JSON |
| 🚩 - » | JSON 오브젝트, JSON 배열 속 데이터 텍스트로 불러오기 | '{"a":{"a":"c"}, "b":{"b":"d"}}' :: json - >> 'a' | TEXT |
| 🚩 # > | 특정한 경로의 값을 가져옴 | '{"a":{"b":{"c":"d"}}}' :: json #> '{"a", "b", "c"}' | JSON |
| 🚩 # » | 특정한 경로의 값을 TEXT 데이터 타입으로 가져옴 | '{"a":[{"b":"d"}, {"c":"f"}]}' :: json #>> '{"a", 0, "b"}' | TEXT |
| ? | JSONB에 해당 문자열을 키 값으로 존재하는지 판별 | '{"a":0, "b":1}' :: jsonb ? 'a' | boolean,NULL |
?| | JSONB에 배열 속 원소가 키 값으로 하나 이상 존재하는지 판별 | '{"a":0, "b":1, "c":2}' :: jsonb ?| array['b', 'd'] | boolean,NULL |
| ?& | JSONB에 배열 속 원소가 키 값으로 모두 존재하는지 판별 | '{"a":0, "b":1, "c":2}' :: jsonb ?& array['b', 'd'] | boolean,NULL |
| 🚩 - | - JSONB 오브젝트의 하나 이상의 원소를 삭제 - JSONB 배열의 해당 인덱스 번호의 원소를 삭제 | '{"a":0, "b":1}' :: jsonb - 'b' | JSONB |
| 연산자/함수 | 설명 | 예시 | 예상결과 |
|---|---|---|---|
| 🚩 json_build_object() | JSON 오브젝트 생성함수 | json_build_object("<키1>", "<값1>", "<키2>", "<값2>", ...) | JSON |
| 🚩 json_build_array() | JSON 형식으로 JSON배열 생성함수 | json_build_array("<원소1>", "<원소2>", "<원소3>", ...) | JSON |
| 🚩 json_array_length() | JSON 배열 원소의 개수 | json_array_length(<JSON>) | INTEGER |
| 🚩 json_each() | 키, 밸류 값 쌍을 JSON 데이터 타입의 컬럼으로 정리 | json_each(<JSON 오브젝트>) | JSON |
| 🚩 json_array_elements() | JSON 배열 속 원소를 컬럼으로 불러옴 | json_array_elements(<JSON 배열>) | JSON |
| 🚩 json_agg() | null을 포함해 json 배열로 집계한 값 | 상세참조 | - |
| 🚩 jsonb_agg() | null을 포함해 jsonb배열로 집계한 값 | 상세참조 | - |
| 🚩 json_object_agg (name, value) | name-value 쌍을 json 개체로 집계한 값 (value는 null포함, name은 미포함) | 상세참조 | - |
| 🚩 jsonb_object_agg (name, value) | name-value 쌍을 json 개체로 집계한 값 (value는 null 포함, name은 미포함) | 상세참조 | - |
1. - >
1
2
SELECT '{"a":"a1", "b":"b1", "c":"c1"}' :: json -> 'a'; // 'a1'
SELECT '[{"a":"a1"}, {"b": "b1"}, {"c":"c1"}]' :: json -> 1; // "{"b": "b1"}"
2. - >>
1
2
3
SELECT
	'{"a":{"a":"c"}, "b":{"b":"d"}}' :: json ->> 'a' // "{"a":"c"}"
;
3. # >
1
2
3
SELECT
	'{"a":{"b":{"c":"d"}}}' :: json #> '{"a", "b", "c"}' // "d"
;
4. # >>
1
2
3
SELECT
	'{"a":[{"b":"d"}, {"c":"f"}]}' :: json #>> '{"a", 0, "b"}' // "d"
;
5. -
1
2
3
SELECT
	'{"a":0, "b":1}' :: jsonb - 'b' // "{"a": 0}"
;
6. json_build_object()
1
2
3
SELECT
	json_build_object('a', 1, 'b', 2) // "{"a" : 1, "b" : 2}"
;
7. json_build_array()
1
2
3
SELECT
	json_build_array('a', 1, 'b', 2) // "["a", 1, "b", 2]"
;
8. json_array_length()
1
2
3
SELECT
	json_array_length('["a", 1, "b", 2]') // 4
;
9. json_each()
1
2
3
4
5
6
7
8
9
10
SELECT * FROM
	json_each('{"JAMES":"HANDSOME", "JASON":"UGLY"}')
;

// 결과
key  |   value
-------+------------
 JAMES | "HANDSOME"
 JASON | "UGLY"
(2개 행)
10. json_array_elements()
1
2
3
4
5
6
7
8
9
10
11
12
SELECT * FROM
	json_array_elements('[1, "a", {"b":"c"}, ["d", 2, 3]]')
;

// 결과
value
-------------
 1
 "a"
 {"b":"c"}
 ["d", 2, 3]
(4개 행)
11. json_agg()
1
2
3
4
5
6
7
8
9
SELECT * FROM order3;

// 결과
id |                           odr
----+---------------------------------------------------------
  1 | {"custormer":"111", "books":{"id":"a", "name":"aBook"}}
  2 | {"custormer":"222", "books":{"id":"b", "name":"bBook"}}
  3 | {"custormer":"333", "books":{"id":"c", "name":"cBook"}}
(3개 행)
1
2
3
4
5
6
7
8
9
10
11
-- id 칼럼을 그룹으로 지정, odr칼럼 내 데이터를 집계

SELECT id, json_agg(odr) FROM order3 GROUP BY 1;

// 결과
id |                         json_agg
----+-----------------------------------------------------------
  3 | [{"custormer":"333", "books":{"id":"c", "name":"cBook"}}]
  1 | [{"custormer":"111", "books":{"id":"a", "name":"aBook"}}]
  2 | [{"custormer":"222", "books":{"id":"b", "name":"bBook"}}]
(3개 행)
12. jsonb_agg()
1
2
3
4
5
6
7
8
9
SELECT * FROM order3;

// 결과
id |                           odr
----+---------------------------------------------------------
  1 | {"custormer":"111", "books":{"id":"a", "name":"aBook"}}
  2 | {"custormer":"222", "books":{"id":"b", "name":"bBook"}}
  3 | {"custormer":"333", "books":{"id":"c", "name":"cBook"}}
(3개 행)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
-- id 칼럼을 그룹으로 지정, odr칼럼 내 데이터를 집계

SELECT id, jsonb_agg(odr) FROM order3 GROUP BY 1;

// 결과(JSONB)
id |                           jsonb_agg
----+---------------------------------------------------------------
  3 | [{"books": {"id": "c", "name": "cBook"}, "custormer": "333"}]
  1 | [{"books": {"id": "a", "name": "aBook"}, "custormer": "111"}]
  2 | [{"books": {"id": "b", "name": "bBook"}, "custormer": "222"}]
(3개 행)

// 결과(JSON)
id |                         json_agg
----+-----------------------------------------------------------
  3 | [{"custormer":"333", "books":{"id":"c", "name":"cBook"}}]
  1 | [{"custormer":"111", "books":{"id":"a", "name":"aBook"}}]
  2 | [{"custormer":"222", "books":{"id":"b", "name":"bBook"}}]
(3개 행)
13. json_object_agg(name, value)
1
2
3
4
5
6
7
8
9
SELECT * FROM order3;

// 결과
id |                           odr
----+---------------------------------------------------------
  1 | {"custormer":"111", "books":{"id":"a", "name":"aBook"}}
  2 | {"custormer":"222", "books":{"id":"b", "name":"bBook"}}
  3 | {"custormer":"333", "books":{"id":"c", "name":"cBook"}}
(3개 행)
1
2
3
4
5
6
7
8
9
10
11
SELECT
	json_object_agg(id, odr)
FROM order3
;

// 출력결과
"{
 ""1"" : {""custormer"":""111"", ""books"":{""id"":""a"", ""name"":""aBook""}},
 ""2"" : {""custormer"":""222"", ""books"":{""id"":""b"", ""name"":""bBook""}},
 ""3"" : {""custormer"":""333"", ""books"":{""id"":""c"", ""name"":""cBook""}}
 }"
14. jsonb_object_agg(name, value)
1
2
3
4
5
6
7
8
9
SELECT * FROM order3;

// 결과
id |                           odr
----+---------------------------------------------------------
  1 | {"custormer":"111", "books":{"id":"a", "name":"aBook"}}
  2 | {"custormer":"222", "books":{"id":"b", "name":"bBook"}}
  3 | {"custormer":"333", "books":{"id":"c", "name":"cBook"}}
(3개 행)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
SELECT
	jsonb_object_agg(id, odr)
FROM order3
;

// 출력결과(JSONB)
"{
 ""1"": {""books"": {""id"": ""a"", ""name"": ""aBook""}, ""custormer"": ""111""},
 ""2"": {""books"": {""id"": ""b"", ""name"": ""bBook""}, ""custormer"": ""222""},
 ""3"": {""books"": {""id"": ""c"", ""name"": ""cBook""}, ""custormer"": ""333""}
 }"

// 출력결과(JSON)
"{
 ""1"" : {""custormer"":""111"", ""books"":{""id"":""a"", ""name"":""aBook""}},
 ""2"" : {""custormer"":""222"", ""books"":{""id"":""b"", ""name"":""bBook""}},
 ""3"" : {""custormer"":""333"", ""books"":{""id"":""c"", ""name"":""cBook""}}
 }"
2) 조인
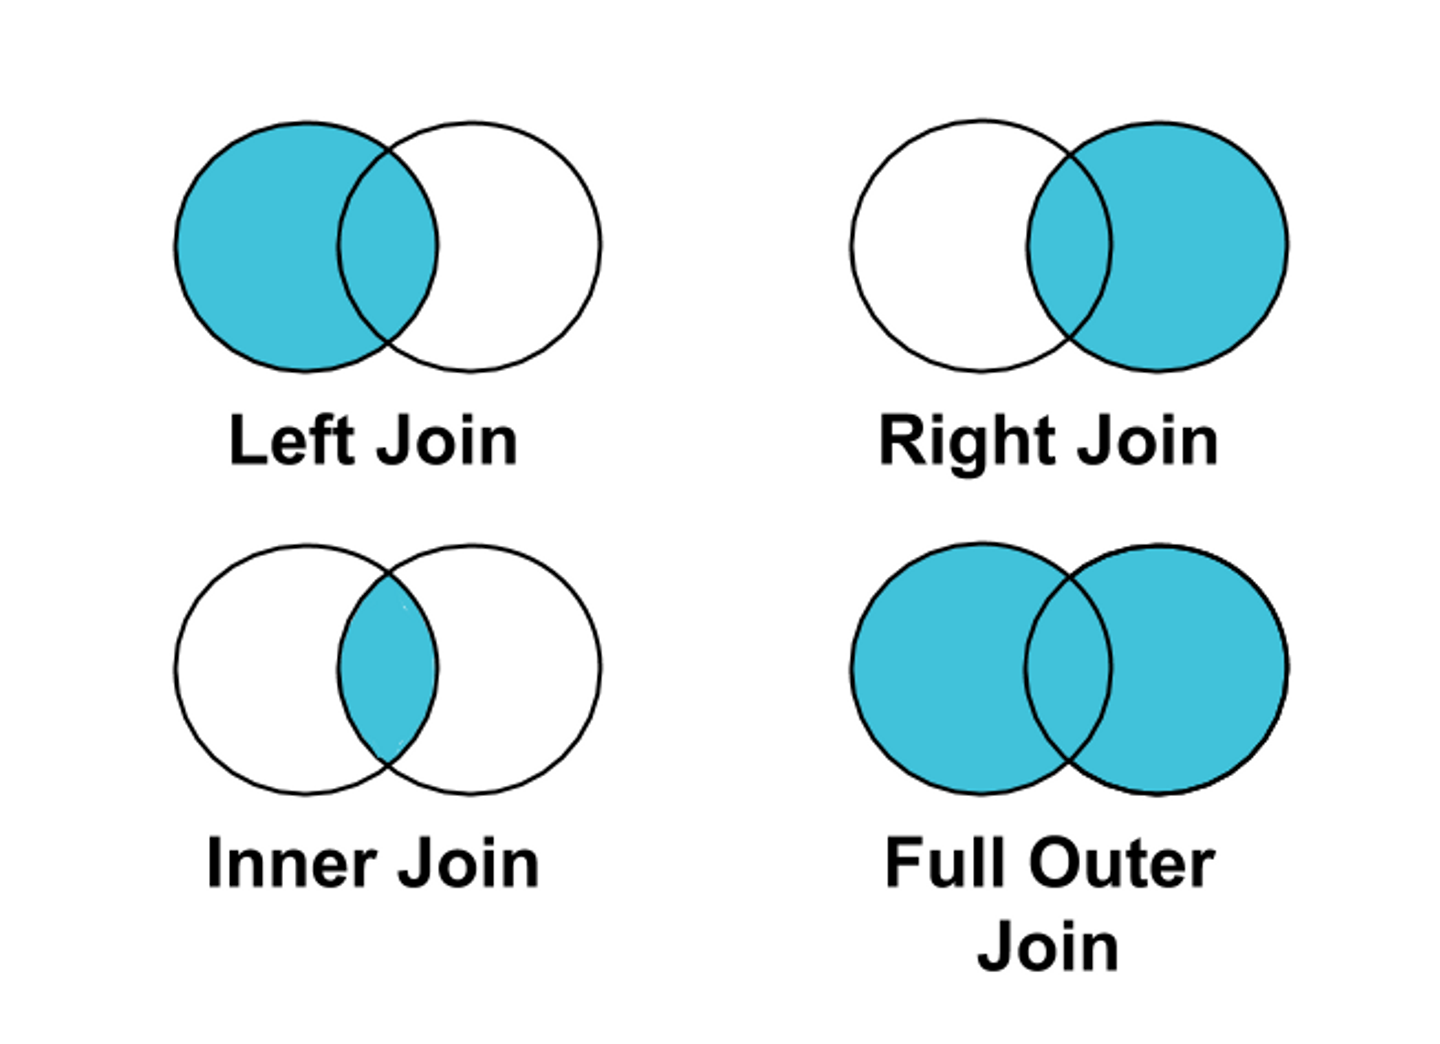
INNER JOIN
다음 예시는 모두 결과가 같으며, 성능 상 차이는 없다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
SELECT
	pg_database.dattablespace AS dtspcoid, datname, pg_database.oid,
	pg_tablespace.oid AS spcoid, spcname, spcowner
FROM pg_database, pg_tablespace WHERE pg_database.dattablespace = pg_tablespace.oid;

// 결과
dtspcoid |  datname  |  oid  | spcoid |   spcname    | spcowner
----------+-----------+-------+--------+--------------+----------
     1663 | postgres  | 13442 |   1663 | pg_default   |       10
     1663 | test      | 16394 |   1663 | pg_default   |       10
     1663 | template1 |     1 |   1663 | pg_default   |       10
     1663 | template0 | 13441 |   1663 | pg_default   |       10
    16735 | mytable   | 16736 |  16735 | mytablespace |       10
    16746 | mytest    | 16747 |  16746 | tbs1         |       10
    16748 | mytest2   | 16749 |  16748 | tbs2         |       10
     1663 | testdb    | 16757 |   1663 | pg_default   |       10
     1663 | newuserdb | 16774 |   1663 | pg_default   |       10
(9개 행)

SELECT
	pg_database.dattablespace AS dtspcoid, datname, pg_database.oid,
	pg_tablespace.oid AS spcoid, spcname, spcowner
FROM pg_database INNER JOIN pg_tablespace ON pg_database.dattablespace = pg_tablespace.oid;

// 결과
dtspcoid |  datname  |  oid  | spcoid |   spcname    | spcowner
----------+-----------+-------+--------+--------------+----------
     1663 | postgres  | 13442 |   1663 | pg_default   |       10
     1663 | test      | 16394 |   1663 | pg_default   |       10
     1663 | template1 |     1 |   1663 | pg_default   |       10
     1663 | template0 | 13441 |   1663 | pg_default   |       10
    16735 | mytable   | 16736 |  16735 | mytablespace |       10
    16746 | mytest    | 16747 |  16746 | tbs1         |       10
    16748 | mytest2   | 16749 |  16748 | tbs2         |       10
     1663 | testdb    | 16757 |   1663 | pg_default   |       10
     1663 | newuserdb | 16774 |   1663 | pg_default   |       10
(9개 행)

SELECT
	pg_database.dattablespace AS dtspcoid, datname, pg_database.oid,
	pg_tablespace.oid AS spcoid, spcname, spcowner
FROM (
	pg_database JOIN pg_tablespace ON pg_database.dattablespace = pg_tablespace.oid
);

// 결과
dtspcoid |  datname  |  oid  | spcoid |   spcname    | spcowner
----------+-----------+-------+--------+--------------+----------
     1663 | postgres  | 13442 |   1663 | pg_default   |       10
     1663 | test      | 16394 |   1663 | pg_default   |       10
     1663 | template1 |     1 |   1663 | pg_default   |       10
     1663 | template0 | 13441 |   1663 | pg_default   |       10
    16735 | mytable   | 16736 |  16735 | mytablespace |       10
    16746 | mytest    | 16747 |  16746 | tbs1         |       10
    16748 | mytest2   | 16749 |  16748 | tbs2         |       10
     1663 | testdb    | 16757 |   1663 | pg_default   |       10
     1663 | newuserdb | 16774 |   1663 | pg_default   |       10
(9개 행)
조인 구조 (시각적으로)확인하기
🔰 SHELL
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
EXPLAIN ([ANALYZE]) --추가
SELECT
	pg_database.dattablespace AS dtspcoid, datname, pg_database.oid,
	pg_tablespace.oid AS spcoid, spcname, spcowner
FROM (
	pg_database JOIN pg_tablespace ON pg_database.dattablespace = pg_tablespace.oid
);

// 결과
QUERY PLAN
--------------------------------------------------------------------------
 Nested Loop  (cost=0.00..2.09 rows=2 width=144)
   Join Filter: (pg_database.dattablespace = pg_tablespace.oid)
   ->  Seq Scan on pg_database  (cost=0.00..1.02 rows=2 width=72)
   ->  Materialize  (cost=0.00..1.03 rows=2 width=72)
         ->  Seq Scan on pg_tablespace  (cost=0.00..1.02 rows=2 width=72)
(5개 행)
🔰 PgAdmin
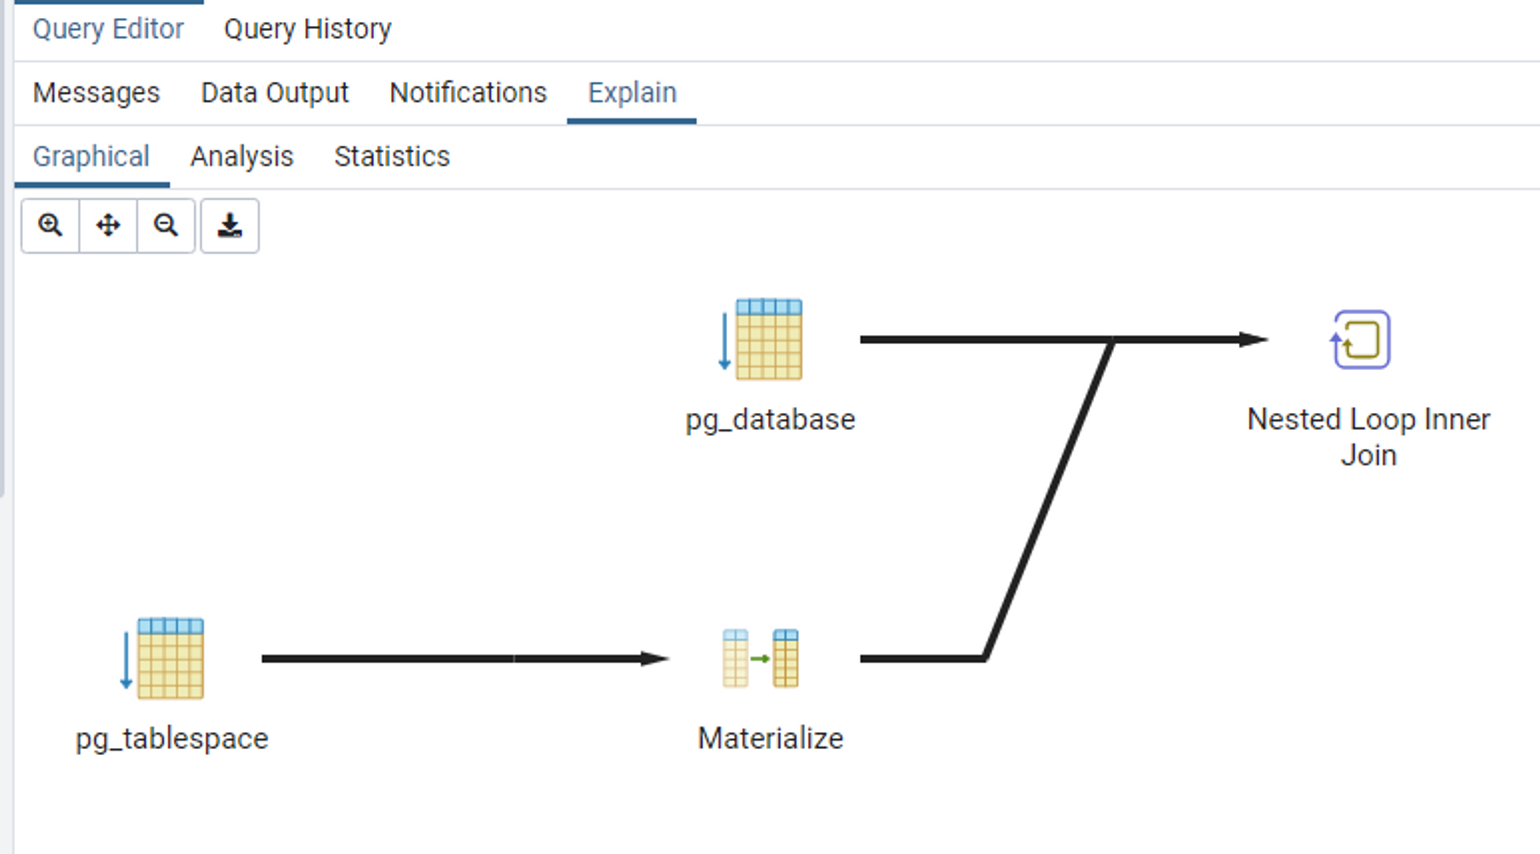
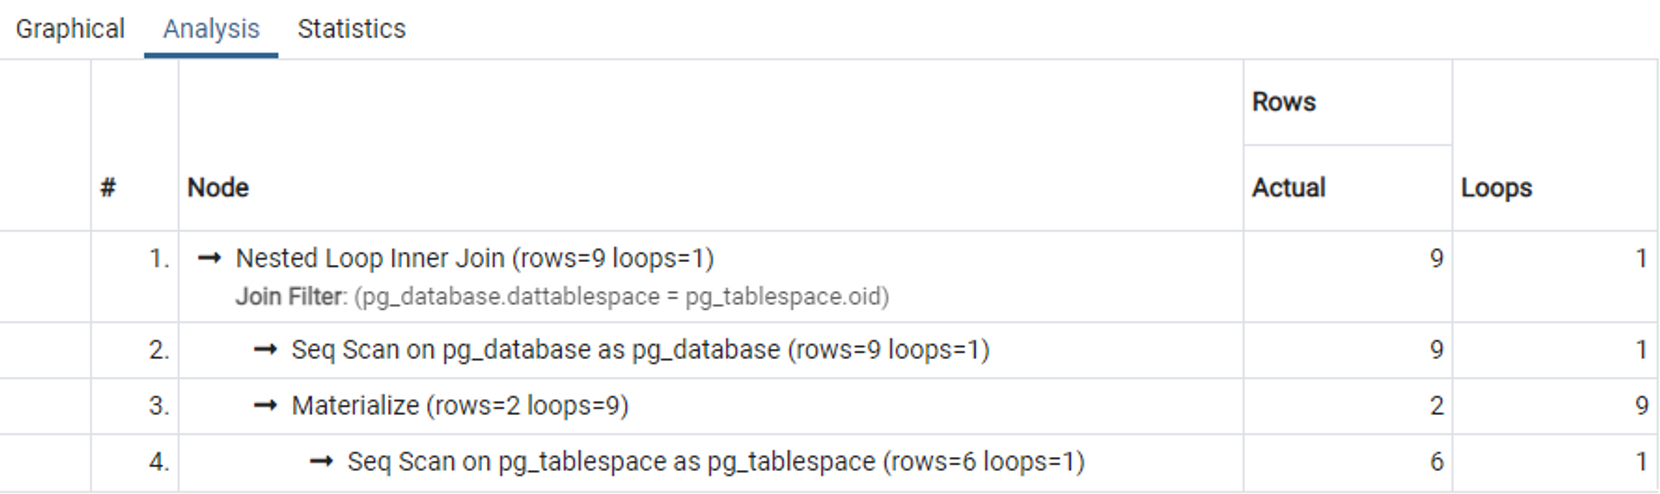
LEFT OUTER JOIN
명령어 앞에 쓰인 테이블을 기준으로 뒤에 쓰인 테이블과 연결되는 정보를 불러오고, 만약 연결된 정보가 없다면 NULL 값 출력.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
SELECT
	pg_tablespace.oid AS spcoid,
	spcname,
	spcowner
FROM pg_tablespace;

// 결과(6개 행)
spcoid |   spcname    | spcowner
--------+--------------+----------
   1663 | pg_default   |       10
   1664 | pg_global    |       10
  16730 | test         |       10
  16735 | mytablespace |       10
  16746 | tbs1         |       10
  16748 | tbs2         |       10
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
SELECT
	pg_database.dattablespace AS dtspcoid,
	datname, pg_database.oid
FROM pg_database;

// 결과(9개 행)
dtspcoid |  datname  |  oid
----------+-----------+-------
     1663 | postgres  | 13442
     1663 | test      | 16394
     1663 | template1 |     1
     1663 | template0 | 13441
    16735 | mytable   | 16736
    16746 | mytest    | 16747
    16748 | mytest2   | 16749
     1663 | testdb    | 16757
     1663 | newuserdb | 16774
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
SELECT
	pg_database.dattablespace AS dtspcoid, datname, pg_database.oid,
	pg_tablespace.oid AS spcoid, spcname, spcowner
FROM pg_tablespace LEFT JOIN pg_database ON pg_database.dattablespace = pg_tablespace.oid;

// 결과(11개 행)
dtspcoid |  datname  |  oid  | spcoid |   spcname    | spcowner
----------+-----------+-------+--------+--------------+----------
     1663 | postgres  | 13442 |   1663 | pg_default   |       10
     1663 | test      | 16394 |   1663 | pg_default   |       10
     1663 | template1 |     1 |   1663 | pg_default   |       10
     1663 | template0 | 13441 |   1663 | pg_default   |       10
    16735 | mytable   | 16736 |  16735 | mytablespace |       10
    16746 | mytest    | 16747 |  16746 | tbs1         |       10
    16748 | mytest2   | 16749 |  16748 | tbs2         |       10
     1663 | testdb    | 16757 |   1663 | pg_default   |       10
     1663 | newuserdb | 16774 |   1663 | pg_default   |       10
   (NULL) |  (NULL)   | (NULL)|  16730 | test         |       10
   (NULL) |  (NULL)   | (NULL)|   1664 | pg_global    |       10
RIGHT OUTER JOIN
명령어 뒤에 쓰인 테이블을 기준으로 앞에 쓰인 테이블과 연결되는 정보를 불러오고, 만약 연결된 정보가 없다면 NULL 값 출력.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
SELECT
	pg_database.dattablespace AS dtspcoid, datname, pg_database.oid,
	pg_tablespace.oid AS spcoid, spcname, spcowner
FROM pg_tablespace RIGHT JOIN pg_database ON pg_database.dattablespace = pg_tablespace.oid;

// 결과(9개 행)
dtspcoid |  datname  |  oid  | spcoid |   spcname    | spcowner
----------+-----------+-------+--------+--------------+----------
     1663 | postgres  | 13442 |   1663 | pg_default   |       10
     1663 | test      | 16394 |   1663 | pg_default   |       10
     1663 | template1 |     1 |   1663 | pg_default   |       10
     1663 | template0 | 13441 |   1663 | pg_default   |       10
    16735 | mytable   | 16736 |  16735 | mytablespace |       10
    16746 | mytest    | 16747 |  16746 | tbs1         |       10
    16748 | mytest2   | 16749 |  16748 | tbs2         |       10
     1663 | testdb    | 16757 |   1663 | pg_default   |       10
     1663 | newuserdb | 16774 |   1663 | pg_default   |       10
FULL OUTER JOIN
연결된 로우는 서로 연결하여 출력하고, 서로 연결되지 않은 로우는 연결되지 않은 부분의 정보를 NULL 값으로 비워둔 채 출력한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
SELECT
	pg_database.dattablespace AS dtspcoid, datname, pg_database.oid,
	pg_tablespace.oid AS spcoid, spcname, spcowner
FROM pg_tablespace FULL OUTER JOIN pg_database ON pg_database.dattablespace = pg_tablespace.oid;

// 결과(11개 행)
dtspcoid |  datname  |  oid  | spcoid |   spcname    | spcowner
----------+-----------+-------+--------+--------------+----------
     1663 | postgres  | 13442 |   1663 | pg_default   |       10
     1663 | test      | 16394 |   1663 | pg_default   |       10
     1663 | template1 |     1 |   1663 | pg_default   |       10
     1663 | template0 | 13441 |   1663 | pg_default   |       10
    16735 | mytable   | 16736 |  16735 | mytablespace |       10
    16746 | mytest    | 16747 |  16746 | tbs1         |       10
    16748 | mytest2   | 16749 |  16748 | tbs2         |       10
     1663 | testdb    | 16757 |   1663 | pg_default   |       10
     1663 | newuserdb | 16774 |   1663 | pg_default   |       10
   (NULL) |  (NULL)   | (NULL)|  16730 | test         |       10
   (NULL) |  (NULL)   | (NULL)|   1664 | pg_global    |       10
3) 인덱스
특징
- 쿼리를 수행할 때 인덱스가 없다면 모든 로우를 일일이 조회해야 한다. 인덱스는 쿼리 작업을 매우 효율적으로 만들어준다.
- 인덱스가 생성된 상태에서 새로운 로우를 삽입하거나 제거하는 작업을 빈번하게 할 때, 매번 인덱스를 업데이트해야 하기 때문에 속도 저하가 발생할 수 있다.
- 단순 인덱스를 만들면 해당 컬럼만 조회할 때 사용 가능하며, 다수의 컬럼을 대상으로 조회할 대는 복합 인덱스가 효율적이다.
- 복합 인덱스는 순서가 중요하다.
B-Tree 인덱스
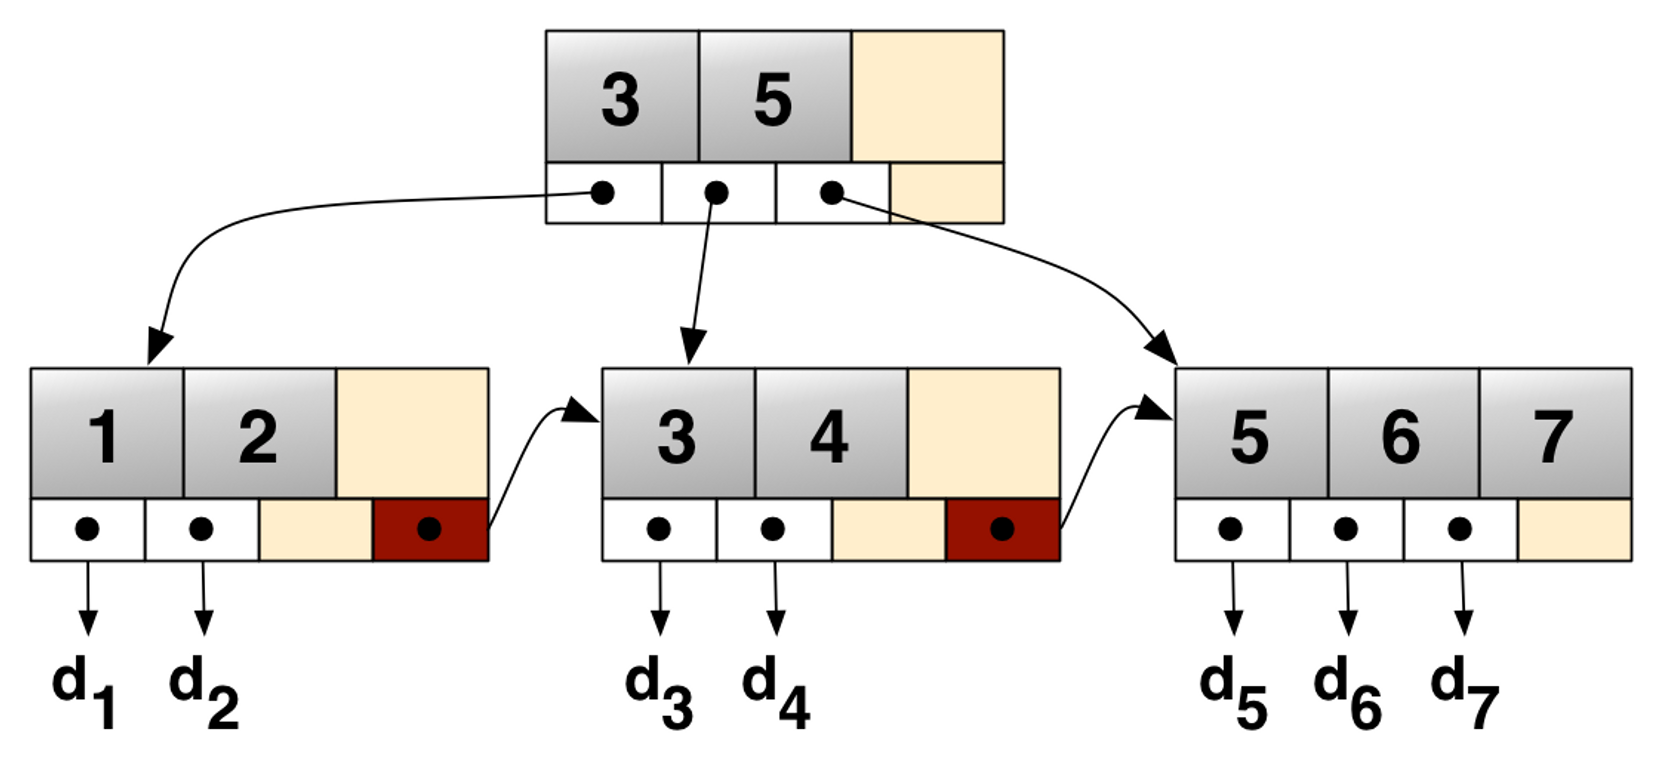
- 자식 노드의 최대 숫자가 2보다 큰 트리 구조.
- 각 노드에 있는 키들은 전부 정렬되어 있으며, 부모-자식 노드가 연결되어 있다.
- 부모- 자식간 연결된 노드는 두 키 값 사이의 값들만 가져야 한다.
- 이런 식으로 정렬된 상태에서 노드를 거슬러 가며 값을 대조하는 방식으로 검색할 수 있다.
- PK 키를 생성하면 자동으로 생성되는 방식의 인덱스.
💡
단점: 자식 노드가 많아지거나, 반대로 하나의 노드에 키 값이 적게 들어있게 된다면 검색 효율이 떨어지게 된다. 그래서 검색할 때 가장 적은 횟수의 조회를 하도록 정해진 규칙에 맞춰 인덱스를 정리해야 할 필요가 있다(균형 맞춤).
1
2
3
4
5
6
7
8
9
10
// B-tree 인덱스 생성 : 옵션을 기재하지 않아도 기본값이 B-Tree 방식임.
-- `단일 칼럼 인덱스` : 한 가지 종류의 인덱스 컬럼 값을 갖는 방식(ex. PK)
CREATE INDEX [index_name] ON [table_name] USING btree ([column_name]);
-- `복합 칼럼 인덱스` : 두 개 이상의 컬럼 값을 갖는 방식.
-- (두 컬럼의 값 중 어떤 것을 우선으로 설정할지 정해주어야 함)
CREATE INDEX [index_name]
	ON [table_name] ([column_name1] [ASC|DESC], [column_name2] [ASC|DESC]);
-- `부분 인덱스` : 컬럼의 모든 값이 아닌, 특정 조건에 맞는 값에 대해서만 인덱스 생성.
CREATE INDEX [index_name] ON [table_name]([column_name]) WHERE [condition]
-- ex) CREATE INDEX male_index ON male(isHandsome) WHERE isHandsome is not null;
1
2
3
4
5
6
7
8
9
10
11
// 생성된 인덱스 확인
-- 생성문과 함께 확인
SELECT * FROM pg_indexes WHERE tablename='[table_name]';
-- 인덱스 테이블 용량과 함께 확인
\di+

// 인덱스 수정
ALTER INDEX <인덱스명> RENAME TO <새로운 인덱스명>;

// 생성된 인덱스 제거
DROP INDEX <인덱스명>;해시 인덱스
해시 인덱스
- 해시화 함수를 통해 값을 더 작은 크기로 변형한 뒤 이 값을 기준으로 B-Tree 구조를 만듦.
- B-Tree 구조만 사용했을 때보다 인덱스 크기가 훨씬 작아짐. 메모리 캐싱, 검색 속도 면에서 좋음.
💡
단점: 해시화 함수를 거치며 원래의 값을 변형하기 때문에, 인덱스한 컬럼 값 사이의 크기 비교가 불가능. 정렬, 비교 연산에 인덱스 활용 불가. 등호 사용으로 값 일치여부만 가능. 때문에, 일반적으로 사용하지 않는 인덱싱 방식.
1
2
// 해시 인덱스 생성
CREATE INDEX [index_name] ON [table_name] UNING HASH([column_name]);
GIN
- Generalized Inverted Index, 전문 검색(Full Text Search)를 주 목적으로 하는 인덱스.
- 주로 긴 문자열이 들어가는 칼럼에 설정.
- 원래의 값 내에 포함된 문자열을 검색하는 데 유용함.
💡 B-Tree와 GIN 인덱스의 차이점
B-tree 인덱스
- 인덱스를 적용하는 컬럼의 값을 변형하지 않고 원래의 값을 이용
- 연산과 같은 값 자체에 대한 탐색에는 효과적이지만 %LIKE% 연산과 같이 검색어가 데이터 값에 포함 되었는지 여부를 확인하는 것에는 적용되기 어려움.
GIN (Generalized Inverted Index) 인덱스
- 인덱스를 적용하는 컬럼의 값을 일정한 규칙에 따라 쪼개고(split), 이렇게 쪼갠 요소들을 사용.
- 이에 따라 포함 여부를 확인하는 경우 보다 효과적으로 동작할 수 있음.
1
2
3
4
5
// GIN 인덱스 (pg_trgm) 생성
CREATE EXTENSION pg_trgm;
CREATE INDEX gin_pid_idx ON patients USING gin ([column_name]);
-- GIN 인덱스는 전문 검색을 위해 tsvector라는 데이터 형식을 사용해야 함.
CREATE INDEX gin_name_idx ON patients USING gin (to_tsvector(['Language'], [column_name]));
💡
to_tsvector: 벡터로 변환해 주는 함수.tsvector로 긴 글을 변환하면 의미를 갖는 단어만 남게 된다. a, the, on과 같은 연결하는 단어는 추출되지 않는다. 변환된 내용에서 단어를 검색하기 위해선 to_tsquery라는 함수를 사용한다.
(예시) content 칼럼 속 영어로 된 긴 글을 벡터라이징 한 후 단어 검색
4) 뷰
- 실제하지 않는 가상의 테이블.
- 뷰가 생성되면 참조한 테이블과 연결, 뷰가 존재하는 테이블을 삭제하려면 뷰 먼저 삭제하거나 CASCADE 명령 사용.
1
2
3
4
5
6
// 뷰 생성(생성된 뷰를 참조하는 뷰 생성 방법도 동일)
CREATE VIEW [view_name] AS
	SELECT * FROM [table_name];

// 뷰 삭제
DROP VIEW <뷰이름>;
1
2
3
4
5
6
7
8
9
10
11
12
13
14
// 뷰가 존재하는 테이블 삭제하기
DROP TABLE order2;
// 그냥 테이블을 삭제하면 오류 출력
ERROR: 오류:  기타 다른 개체들이 이 개체에 의존하고 있어, order2 테이블 삭제할 수 없음
DETAIL:  view_order2 뷰 의존대상: order2 테이블
HINT:  이 개체와 관계된 모든 개체들을 함께 삭제하려면 DROP ... CASCADE 명령을 사용하십시오

// 뷰를 삭제하거나, CASCADE 명령 사용
DROP TABLE order2 CASCADE;
// 알림:  view_order2 뷰 개체가 덩달아 삭제됨
SELECT * FROM view_order2;
//ERROR: 오류:  "view_order2" 이름의 릴레이션(relation)이 없습니다
LINE 1: SELECT * FROM view_order2;
                      ^
9. 프로시저 함수 & 트리거
1) 프로시저 함수
- 프로시저 언어 : 함수와 트리거를 만드는 데 사용하며, 복잡한 연산 처리가 용이.
- 종류 : PL/pgSQL, PL/TCL, PL/Perl, PL/Python 등.
💡 프로시저 사용을 위해서는 다음과 같이 언어를 설치하는 과정이 필요(DB접속 후 설치)
형식
-
$$...$$은'...'로 대체 가능.
1
2
3
4
5
6
CREATE [OR REPLACE] FUNCTION function_name(param1 type, param2 type)
  RETURN return_type AS $$
    BEGIN
      ...
    END;
$$ LANGUAGE language_name;
예제
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
// 1. 두 정수 a, b를 곱을 리턴
CREATE FUNCTION mul(a INTEGER, b INTEGER)
  RETURNS INTEGER AS $$
    BEGIN
      RETURN a * b;
    END;
$$ LANGUAGE PLpgSQL;

// 실행
SELECT mul(2, 3);

// 결과
mul
-----
   6
(1개 행)
1
2
3
4
5
6
7
8
9
10
11
12
13
// 2. Message로 출력
DO $$
DECLARE
  a integer := 20;
  b integer := 40;
BEGIN
  IF a > b THEN
    RAISE NOTICE 'a가 b보다 더 큽니다.';
  ELSE
    RAISE NOTICE 'a가 b보다 더 크지 않습니다.';
  END IF;
END $$;
// 알림:  a가 b보다 더 크지 않습니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
// 3. 조건에 따라 테이블에 반복 삽입
CREATE OR REPLACE FUNCTION adder(n INTEGER)
  RETURNS INTEGER AS $$
  DECLARE
    result INTEGER := 0;
    BEGIN
      FOR i IN 1..n LOOP
          RAISE NOTICE 'Iterator: %', i;
          result := result + i;
            IF i%2 = 0 THEN
              INSERT INTO info3 VALUES (i, '짝수입니다.', null);
            ELSE
               INSERT INTO info3 VALUES (i, '홀수입니다.', null);
            END IF;
      END LOOP;
      RETURN result;
    END;
$$ LANGUAGE plpgsql;

// 실행
SELECT adder(10);

// 결과
-- info3 테이블
cont_id |    name     | tel
---------+-------------+-----
       1 | 홀수입니다. |
       2 | 짝수입니다. |
       3 | 홀수입니다. |
       4 | 짝수입니다. |
       5 | 홀수입니다. |
       6 | 짝수입니다. |
       7 | 홀수입니다. |
       8 | 짝수입니다. |
       9 | 홀수입니다. |
      10 | 짝수입니다. |
(10개 행)

-- RETURN 값
adder
-------
    55
(1개 행)

-- Message
알림:  Iterator: 1
알림:  Iterator: 2
알림:  Iterator: 3
알림:  Iterator: 4
알림:  Iterator: 5
알림:  Iterator: 6
알림:  Iterator: 7
알림:  Iterator: 8
알림:  Iterator: 9
알림:  Iterator: 10
2) 트리거
- 어떤 행동이나 작업을 했을 때, 미리 저장해 놓은 작업이 자동으로 실행되도록 하는 것.
예제
🔰 구독자가 구독 버튼을 누르면 자동으로 구독자 수가 갱신되는 시스템을 트리거로 생성.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
// 구독자 테이블 생성
CREATE TABLE subscriber(
  subs_id   INTEGER,    --구독자 아이디
  subs_name VARCHAR(80) -- 구독자 이름
);

// 구독자 수 테이블 생성
CREATE TABLE sub_number(
  subs_num INTEGER
);

// 구독자 수를 0으로 초기화하기 위해 값을 넣어줌
INSERT INTO sub_number VALUES(0);

// 구독자가 삽입(insert)되면 구독자수를 자동으로 늘리는 트리거 생성
CREATE OR REPLACE FUNCTION sub_like()
  RETURNS TRIGGER AS $$
    BEGIN
      UPDATE sub_number SET subs_num = subs_num + 1;
      RETURN NULL;
    END;
$$ LANGUAGE PLpgSQL;

// 트리거 실행
CREATE TRIGGER sub_trigger AFTER INSERT ON subscriber
  -- 트리거를 실행시킬 것임을 알려주는 명령어 입력. 삽입 후 트리거 실행이므로 INSERT.
FOR EACH ROW EXECUTE PROCEDURE sub_like()
  -- 이후 트리거 실행 시 실행할 함수 sub_like()를 수행하는 코드 입력
;

// 구독자 테이블에 데이터 입력
INSERT INTO subscriber VALUES (1, 'A'), (2, 'B'), (3, 'C');

// 구독자 테이블에 데이터가 늘어날 때마다 구독자 수 테이블도 트리거에 의해 숫자가 하나씩 증가
SELECT * FROM sub_number; // 3
💡 프로시저 함수, 트리거, 사용자 정의 함수의 차이
프로시저
- 어떤 작업에 대한 절차적 일괄처리 작업에 사용.
- 반복적인 트랜잭션을 수행할 수 있는 PL/SQL 블록.
- DB내에 미리 컴파일되어 저장되어 있다가 필요할 시 매번 사용 가능.
트리거
- 지정된 이벤트 발생시 자동으로 실행되는 프로시저와 같은 것.
명시적으로 호출 필요없이 DDL, DML 또는 일부 DB 작업(LOGOFF, SHUTDOWN)에 대한 응답으로 호출 가능.
Ex) 입고 테이블에 insert 트리거를 작성하면, 테이블에 자료 추가될 때
상품 테이블에 재고 수량이 되도록 트리거를 작성한다.
사용자정의함수
- 프로시저와 차이는 리턴값의 유무.
- 프로시저는 수행하는 절차가 목적이라 리턴값이 없어도 되지만, 함수는 결과 도출이 목적이기에 리턴값이 존재한다. 단 하나의 리턴값만 있어야 한다.
10. 질문과 보충사항
💡 감사합니다. 질문과 보충했으면 좋을 것 같은 사항들을 말씀해주세요.
11. 색인과 출처
- 특징
- 1) 포스트그레스큐엘이란?
-
ORACLE,MySQL,MS SQL Server,PostgreSQL: RDBMS의 종류 - 2) 역사 - IngresDB : 대규모 상용 및 정부 애플리케이션을 지원하기 위한 전용 SQL 관계형 데이터베이스 관리 시스템, C로 작성됨 - 3) 키워드
- ANSI/ISO 규격의 SQL : SQL의 표준화는 ANSI(미국규격협회)와 ISO(국제표준화기구)의 2개 표준화 단체에 의해 진행되고 있다
- `Reliable(신뢰성) : 소프트웨어 품질 목표 중 옳고 일관된 결과를 얻기 위해 요구된 기능을 수행할 수 있는 정도를 나타냄(=주어진 시간동안 주어진 기능을 오류 없이 수행하는 정도)
-
ACID: 원자성, 일관성, 고립성, 지속성 `MVCC(다중 버전 동시성 제어)
[1]Multi-Version Concurrency Control, 동시 접근을 허용하는 데이터베이스에서 동시성을 제어하기 위해 사용하는 방법 중 하나. [2]DBMS에서 쓰기세션-읽기세션이 서로를 블로킹하지 않고, 서로 다른 세션이 동일 데이터에 접근했을 때 각각의 스냅샷 이미지를 보장해주는 메커니즘. 변경된 내용은 UNDO영역에 기록되며, 사용자는 마지막 버전의 데이터를 읽게 됨.
- 로우 레벨 락킹(Row Level Locking) : Table Locking은 Table에 대하여 Query문이 수행될 때, 그 Table전체에 대해 Locking을 거는 방식. Row Level Locking(행 수준 잠금)은 데이터를 수정하는 경우 해당 Row에만 Locking을 거는 것.
- 로킹(Locking) : 한 번에 한명만 사용할 수 있게 하는 단위.
- 블로킹
- 전체 텍스트 검색(Full-text search) : document를 전처리하여 빠르게 검색이 가능하도록 하는 기능[document를 token으로 해체(단어 분리)-token을 lexem으로 변환(정규화)-전처리된 document를 검색하기 좋은 형태로 저장(정렬된 배열로 표현)](예시)
- 테이블 파티셔닝 : DB 시스템의 용량과 성능 관리를 위해, 대용량 테이블을 파티션이라는 작은 단위로 나누어 관리하는 것(PostgreSQL 10 [1], [2], [공식])
테이블 스페이스[1] 오라클과 PostgreSQL에서만 사용되는 개념. psql에서 DB는 PGDATA라는 환경변수에 지정된 디렉토리를 통째로 DB로 사용하는데, 그 하위에 테이블이 파일로 생성된다. 즉, 테이블 스페이스를 따로 생성하지 않아도 DB에 사용자 테이블을 만들 수 있다. 결론적으로, DB로 지정된 디렉토리 전체가 하나의 기본 테이블 스페이스로 인식된다. (*DB관리자에 의해 데이터베이스의 객체가 저장될 수 있는 파일시스템의 경로) [2]데이터베이스 객체가 파일 시스템상에 저장되는 물리적인 공간. Table Space를 이용하여 데이터베이스의 목적에 따라 저장소를 다르게 사용하는 운영이 가능해지며, 장애 대응 및 복구 등의 용도로도 활용이 가능. [공식]데이터베이스 관리자가 데이터베이스 객체를 나타내는 파일을 저장할 수 있는 파일 시스템의 위치를 정의할 수 있게 하는 것.
- `호스트 기반 인증(host-based authentication) : 호스트(IP주소를 갖는 시스템, 네트워크에 연결되어 있는 컴퓨터) 기반 인증[1][2][3]
- 호스트 기반 침입 탐지 시스템(Host-based Intrusion Detection System, HIDS) : 컴퓨터 시스템의 내부를 감시하고 분석하는 데 더 중점을 둔다
- Object-level 권한 : 오브젝트(table, column, view, foreign table, sequence, database, foreign-data wrapper, foreign server, function, procedural language, schema, tablespace) 단위로 접근이 허용 또는 거부
-
SSL(Secure Socket Layer)통신: 보안 프로토콜이며, 일반적으로 https://형태 `스트리밍 복제(Streaming Replication)
[1]레코드 기반 로그 전달 방식. TCP 연결 방식을 이용해서 운영 서버와 직접 연결하고, 커밋된 트랜잭션을 즉시 대기 서버로 반영한다. WAL 세그먼트 파일 전달 방식보다 운영 서버의 자료 상태를 거의 실시간으로 동기화하는 방식이다. [2][3]WAL Log를 거의 실시간성으로 전달함으로써(물론 DB 서버 사이에는 Network에 문제가 없어야 한다.) 별다른 지연 없이 모든 DB가 동일한 값을 저장할 수 있게 하는 것. [복제의 한 종류]
- Hot Standby(상시대기) : 서버가 아카이브 파일로 복구 작업 중이거나 대기 모드일 때도 클라이언트가 그 서버로 접속할 수 있으며, 읽기 전용 쿼리를 실행할 수 있는 기능. 현재 운용장비와 예비 운용장비의 구성을 항상 같은 상태로 해두는 것
-
Warm Standby: [1]서버 다중화 요소 중 한 쪽은 사용할 수 없는 Active-Standby(↔ Active-Active)의 세 종류 중 하나. [2]가동 후 즉시 이용은 불가능 하지만, 어느정도 준비가 갖추어져있는 정도. - Cold Standby : 예비 운용장비를 평소에는 사용하지 않고, 현재 운용장비에 장애가 발생하면 그 때 예비 운용장비에 연결하는 운용체제를 말한다.
- 다중화 : 장애가 발생하더라도 예비 운용장비로 시스템의 기능을 계속할 수 있도록 하는 것.
- Active-Active / Active-Standby : (A-A)부하분산(로드밸런싱)을 통해 기능 또는 성격에 따라 1번 또는 2번 서버로 나누어서 처리하도록 구상. (A-S)서버를 이중화하여 구성하지만 장애 시에 서비스를 이전하여 운영하는 형태로 구성. 운영(메인)서버 장애 시 서비스 장애를 즉시 인지하여 서브 서버로 서비스를 이전함.
-
WAL(write ahead log, 선행기입로그) 아카이빙: [1]PostgreSQL에서는 미리 쓰기 기록을 데이터베이스 클러스터 디렉토리 안 pg_xlog/디렉토리에서 관리함. 이 로그는 데이터베이스의 데이터 파일에 대한 모든 조작 기록을 보관함. 서버가 갑자기 중지되었을 경우, 미처리 작업을 로그에서 읽어서 다시 복구한 후 작업을 완료하기 위함. 어떤 데이터베이스에 쿼리를 날려 변경 이벤트를 실행할 때, 데이터를 변경하기 전에 해당 변경 내용을 로그에 미리 담아두고 이후에 변경한다는 개념. [2]Database 변경 사항만을 저장한 Log - Hot Backup(열린백업) : 데이터베이스가 오픈된 상태에서 백업 가능, 백업 중에도 DB서비스를 제공할 수 있다(↔Cold Backup, 닫힌백업)
- `Point in time recovery(시점복구) : [1]DB 손실, 장애, 과거 데이터 조회 필요성에 의해 특정 시점으로 데이터베이스를 복원해야할 때 행하는 방법. 과거의 특정 시점(Point in Time)으로 복구한다는 의미. [2]
- pg_upgrade : PostgreSQL에서 제공해주는 업그레이드 명령어[공식]
- C/S기반 : Application 방식으로 PC에 app을 깔아서 프로그램을 실행해 접근(↔Web 방식) - 4) 내부 구조[1][2][3][4][5][6]
- DATABASE 구조
- template 테이블
- 스키마
-
MASTER DB - SLAVE DB[1][2] - 권한[1][공식]
- `연결 초기화(Initialize connection)
- Postmaster : PostgreSQL server
- Deamon : 멀티태스킹 운영 체제에서 데몬은 사용자가 직접적으로 제어하지 않고, 백그라운드에서 돌면서 여러 작업을 하는 프로그램을 말한다
- 데몬과 배치 차이점 : 배치는 특정 시간에 작업을 실행하는 프로세스. 지정된 시간 이후에는 자원을 거의 소비하지 않음 / 데몬은 특정 서비스를 위해 백그라운드 상태에서 계속 실행되는 서버 프로세스. 서버가 죽을 때까지 자원을 점유.
Postgres Server- 캐시 : 데이터나 값을 미리 복사해 놓는 임시 장소
-
Dirty Buffer: [1][2]버퍼에 캐시된 이후 변경이 발생했지만, 아직 디스크에 기록되지 않아 데이터 파일 블록과 동기화가 필요한 버퍼 블록. - 5) 세부 기능 및 제한점 -
Nested transactions: 중첩된 트랜잭션 -
Savepoints: 저장점 - 온라인 백업(Online Backup)/열린 백업(Hot Backup) : 운영 중인 데이터베이스에 대해 백업을 수행하는 방식
-
Point in time recovery: 시점 복구 -
Hot Backup: 열린 백업 - `병렬복구(Parallel restore) : 다중 백업(multi-thread backup), 동시 백업을 수행하는 방식
-
Rule System: PostgreSQL 규칙 시스템의 CREATE RULE은 지정된 테이블 또는 보기에 적용되는 새 규칙을 정의함. CREATE OR REPLACE RULE는 새 규칙을 만들거나 동일한 테이블에 대해 동일한 이름의 기존 규칙을 바꿈. -
B-트리: B트리란 Balanced Tree로, 자식을 두개만 가질 수 있던 Binary tree(이진 트리)의 확장개념. 자식 노드의 개수가 2개 이상이고, 데이터를 정렬하여 탐색, 삽입, 삭제 및 순차 접근이 가능하도록 유지하는 트리형 자료구조.[1][](https://beelee.tistory.com/37)[2] R-트리[1]다차원의 공간 데이터를 효과적으로 저장하고 지리정보와 관련된 질의를 빠르게 수행 할 수 있는 트리 자료 구조. [2]다차원의 공간 데이터를 저장하는 색인. 이를테면, 지리학에서 R 트리는 “현재 위치에서 200km 이내의 모든 도시를 찾아라”와 같은 질의에 대해 빠르게 답을 줄 수 있다.
- 해시 인덱스 : 검색하고자 하는 값을 찾기 위해 해시함수를 거쳐 키값이 포함된 버켓을 찾아내는 방식
-
버킷: 인덱스 각 키값과 레코드의 주소값등의 정보를 두는 공간[1][2] GiST(Generalized Search Tree) 인덱스[1]GiST는 어떤 운영 클래스가 적용되는지에 따라 다른 인덱스 전략을 사용할 수 있는 균형 잡힌 트리 구조 인덱스 액세스 방식. 이 기능의 경우 인덱스의 유형이 아닌 인프라로 볼 수 있음. 기하학 데이터, 텍스트 검색 문서 등 다양한 GiST 연산자 클래스를 제공. [2] “일반화된 검색 트리”의 줄임말로, 인덱스 작업의 포괄적인 형태. 일반 B-Tree 인덱스 작업으로는 쓸 수 없는 온갖 종류의 비정규 데이터 구조(정수 배열, 분광 데이터 등등)에 대한 검색 속도를 향상시키는 데 GiST를 이용.
- PostgreSQL INDEX
- 절차 언어 : 순서를 명확한 계산법으로서 쉽게 표현할 수 있는 문제 지향 언어로서, 컴퓨터에 처리시키고자 할 때 그 순서를 명확하게 기술함으로써 처리를 쉽게 실행하는 프로그래밍 언어.
- PL/pgSQL : PostgreSQL 데이터베이스 시스템에서 로드가능한 프로시저 언어이자, 절차적 언어라는 특징을 가지고 있음
- 정보 스키마(Information Schema) : 현재 데이터베이스에 정의된 개체에 대한 정보를 포함하는 보기 집합으로 구성[2]
- `국제화(I18N) : 응용 프로그램을 다양한 지역에 맞게 조정하는 시스템
- `현지화(L10N) : 문화, 지역 또는 언어가 다양한 대상 고객을 위해 쉽게 현지화할 수 있는 디자인 및 개발
- 데이터베이스 및 열별 데이터 정렬(Database & Column level collation)
- Array, XML, UUID type
- Auto-increment (sequences)
- SSL, IPv6
-
hstore: [1][2]PostgresSQL에서 기본적으로 제공되는 기능. Key / Value라는 단순한 구조를 갖는 테이블을 정의할 수 있는 확장. - `테이블 상속(Table inheritance) : [1][2] - 6) 경쟁 제품들과의 비교
-
마이그레이션: 서비스 중인 한 어플리케이션 또는 모듈 등을 전혀 다른 환경(OS, 미들웨어, 하드웨어 등) 에서도 돌아갈 수 있도록 전환하는 것을 의미. 예를 들어, C로 개발된 솔라리스 OS 기반 프로그램을 시스템이 노후화되어 리눅스 기반의 새로운 시스템에서 돌아갈 수 있도록 하려면 솔라리스 OS에서 참조하던 라이브러리, API(함수) 등에 대해 동일한 역할을 하는 리눅스 기반의 그것으로 1:1 변환/매핑하는 작업이 필요함. 이런 것이 단순하게 바라본 마이그레이션의 의미.
- 특징
- ORACLE vs PostgreSQL
- 오라클과 포스트그레스큐엘 비교
- BSD : 라이센스 종류
horizontal partitioning
[1]하나의 테이블을 특정 분할 기준(ex. 여, 남)에 따라 수평 분할(레코드로 분할)하는 것. [2] 오라클 파티셔닝 : 대용량 테이블을 물리적인 n개 테이블로 나누는 것(논리적으로 1개 테이블, 물리적으로 n개 테이블)[예제]
- 이기종 시스템 아키텍처(Heterogeneous System Architecture, HSA) : 컴퓨팅 자원을 최대한 활용해 비용 대비 높은 생산성을 얻을 수 있는 효율적인 설계 방식. 쉽게 말해 CPU와 GPU의 벽을 허물고 소프트웨어가 두 부품의 컴퓨팅 자원을 자유롭게 활용한다는 의미. 기업을 예로 들면, 부처 간의 벽을 허물고 하나의 목표를 이루기 위해 모든 인력과 자원을 공유해 업무 효율을 높이는 것.
- Multi-source replication(다중 소스 복제) : 스트림을 사용하여 세 개의 Oracle 데이터베이스 중 스키마에 대한 데이터를 복제하는 방법.
- Source-replica replication(원본 복제)
- 서버 사이드 스크립트 언어 : 웹에서 사용되는 스크립트 언어 중 서버 사이드에서 실행되는 스크립트 언어.
- 맵리듀스 : 구글에서 대용량 데이터 처리를 분산 병렬 컴퓨팅에서 처리하기 위한 목적으로 제작하여 2004년 발표한 소프트웨어 프레임워크. 맵(Map)+리듀스(Reduce)로 이루어져 있으며, Input(데이터 입력) → Splitting(데이터를 쪼개 HDFS에 저장) → Mapping → Shuffling(맵 함수의 결과 취합을 위해 리듀스 함수로 데이터 전달) → Reducing(모든 값을 합쳐 원하는 값 추출) → Final Result과 같은 과정을 거친다.
- ORACLE vs PostgreSQL
- 환경 변수 설정
- 접속
- CRUD
![Untitled]()
- 트리거 & 프로시저
- 프로시저 함수 형식 예제
- 프로시저 함수, 트리거, 사용자 정의 함수의 차이[1][2]
- 트리거 & 프로시저
- 질문과 보충사항
- 그 외