1. 특징
1) 포스트그레스큐엘이란?
![Untitled]()
🛢 Oracle
🗄 MS SQL Server
🐬 MySQL
🐘 PostgreSQL ← NEW!!
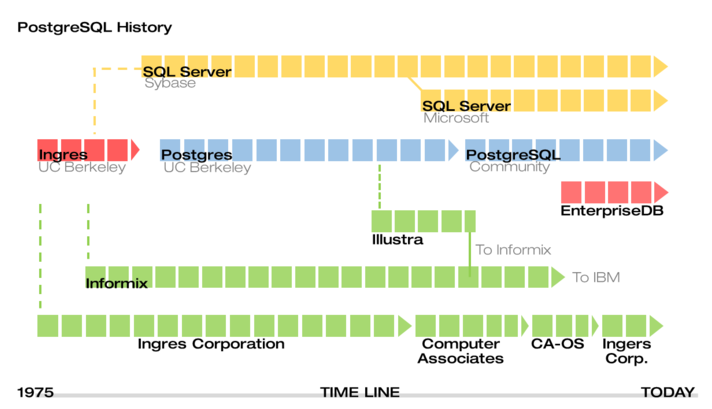
2) 역사
![Untitled]()
- 1977년 미국 UC 버클리 대학
-
Ingres(INteractive Graphics REtrieval System)DB란 이름으로 개발 프로젝트 시작 - 1993년 서비스 종료 후 1997년 PostgreSQL 서비스 시작
3) 키워드
Portable(휴대성)
- C언어로 개발됨
- Windows, Linux, MAC OS/X, Unix Platform 등 다양한 플랫폼 지원
- ANSI / ISO 규격의 SQL 지원
Reliable(신뢰성)
- 신뢰할 수 있는 작업을 보장하기 위해 ACID 및 트랜잭션 지원
- 동시성 성능을 높여주는 MVCC, 로우 레벨 락킹 등 구현
- 다양한 인덱싱 기법 지원
- 유연한 Full-text search 기능
- 다양하고 유연한 복제 방식 지원
- 다양한 프로시저(PL/pgSQL, Perl, Python, Ruby, TCL 등) 언어 지원
- 다양한 인터페이스(JDBC, ODBC, C/C++, .Net, Perl, Python 등) 지원
Scalable(확장성)
- 대용량 처리를 위한 Table Partitioning과 Tablespace 기능 구현 가능
Secure(보안)
- 데이터 암호화, 접근 제어, 로그 감사 3가지로 DB보안
- 호스트 기반 인증, object-level 권한, SSL 통신을 통한 클라이언트와 네트워크 구간의 전송 데이터 암호화
Recovery & Availability(복구, 이용)
- WAL 아카이빙 및 Hot Backup을 통해 Point in time recovery 가능
- Streaming Replication을 기본적으로 동기식, 비동기식의 Hot Standby 서버 구축 가능
Advanced(발전)
- 진보하고 안정적인 오픈소스 RDBMS
- pg_upgrade를 이용, 업그레이드 진행 가능
- 웹 기반, C/S기반의 GUI 관리 도구 제공 : 모니터링, 관리, 튜닝 가능
- 질 좋은 커뮤니티 지원 및 상업적인 지원
- 잘 만든 문서 및 충분한 매뉴얼 제공
4) 내부 구조
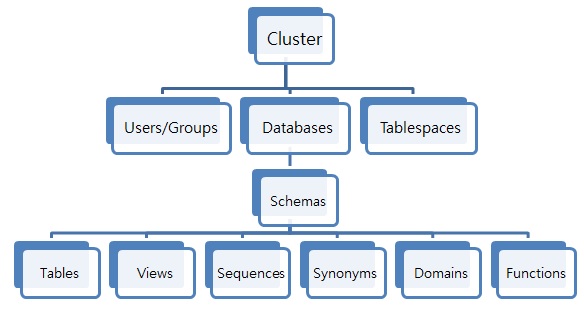
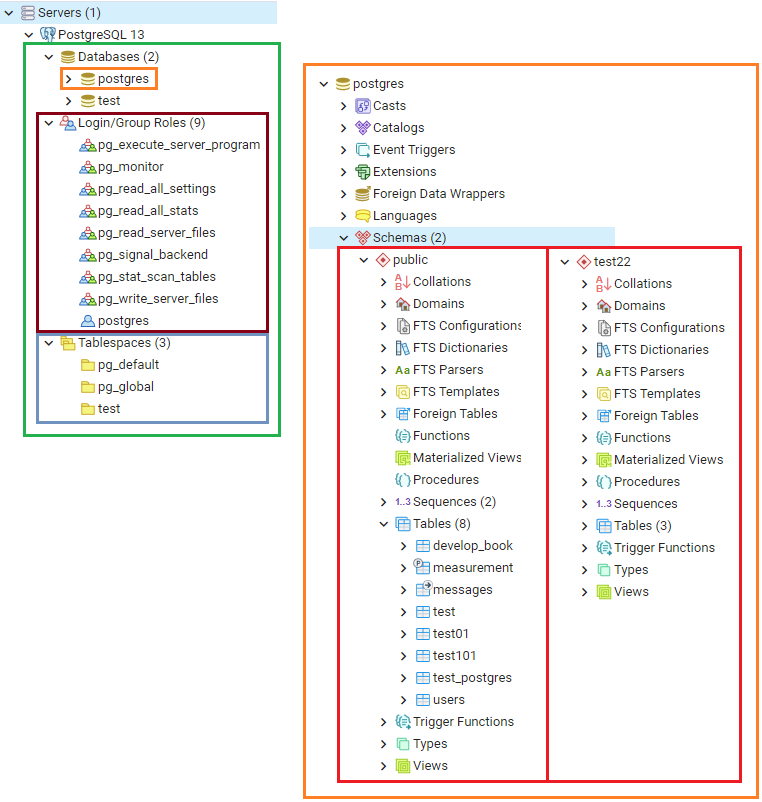
DATABASE 구조
![Untitled]()
![Untitled]()
스키마
- TABLE의 집합, 하나의 DATABASE를 논리적으로 나누는 개념
- 서로 다른 DATABASE에 있는 테이블 간에는 서로 JOIN 불가능
- 데이터베이스 내 서로 다른 스키마 테이블 간에는 JOIN 가능
주요 생성 명령
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
| -- 유저 생성
CREATE USER [username] [[ WITH ] option [ ... ]]
-- 테이블 스페이스 생성
CREATE TABLESPACE [name] LOCATION '[location]';
-- 데이터베이스 생성
CREATE DATABASE [db_name] WITH [TABLESPACE = [tablespace_name]] [AND] OWNER [username];
// CREATE DATABASE testdb WITH OWNER testdb;
-- 스키마 생성
CREATE SCHEMA [sch_name] AUTHORIZATION [username];
// CREATE SCHEMA testdb AUTHORIZATION testuser;
// CREATE SCHEMA testdb_log AUTHORIZATION testuser;
// testdb 내 기본 스키마인 public, testdb, testdb_log 총 3개의 스키마가 생성됨.
-- 스키마에 대한 테이블 생성
CREATE TABLE "[sc_name]".[tb_name] ( ... );
-- 유저 목록 조회
SELECT * FROM pg_shadow;
-- 데이터베이스 목록 조회
SELECT * FROM pg_database;
-- 테이블 스페이스 목록 조회
SELECT * FROM pg_tablespace;
-- 테이블 목록 조회
SELECT * FROM pg_talbes;
|
template 데이터베이스
| oid | datname |
|---|
| 13442 | postgres |
| 16394 | test |
| 1 | template1 |
| 16749 | mytest2 |
| 16747 | mytest |
| 16736 | mytable |
| 13441 | template0 |
💡 CREATE DATABASE 는 실제론 이미 존재하는 데이터베이스를 복사하는 방식으로 동작.
template1 : CREATE DATABASE 명령을 할 때, 기본(default)으로 복사되는 테이블.
- template1 테이블 자체에 사용자가 원하는 요소를 넣어 수정할 수 있다.
- 이후 테이블을 생성 template1 테이블에 있는 요소가 그대로 새로운 테이블에 복사된다.
- 예를 들어, template1에 프로시저 언어 PL/pgSQL을 설치하면, 이후 생성하는 테이블에서 그대로 쓸 수 있다.
template0 : template1의 초기값과 동일한 데이터를 가지고 있음.
- 따라서, template1에 사용자 정의 요소를 추가한 후, 다시 초기화된 데이터베이스를 생성하고 싶다면 template0을 복사.
1
2
3
4
5
| -- pgAdmin
CREATE DATABASE dbname TEMPLATE template[0 | 1];
-- shell
CREATEDB -T template[0 | 1] dbname
|
권한
🔰 GRANT : user, group 혹은 모든 user들에게 해당 객체에 대한 사용권한을 승인.
1
2
| GRANT privilege [,...] ON object [,...]
TO { PUBLIC | GROUP group | username}
|
🔰 REVOKE : 유저,그룹, 혹은 모든 유저로부터 access privilege 를 취소
1
2
3
| REVOKE privilege [,...]
ON object [,...]
FROM { PUBLIC | GROUP gname | username }
|
💡 상세 옵션
privilege
SELECT : 특정 TABLE/VIEW 의 column에 대한 access 을 승인/취소
INSERT : 특정 TABLE의 모든 column 에 데이타의 삽입에 대한 권한 승인/취소
UPDTAE : 특정 TABLE의 모든 column 의 갱신에 대한 권한 승인/취소
DELETE : 특정 TABLE 의 row 의 삭제에 대한 권한 승인/취소
RULE : 특정 TABLE/VIEW에 대한 rule 을 정의하는 권한에 대한 승인/취소
ALL : 모든 권한을 승인/취소한다.
-
object : 적용될 수 있는 객체 : table, view, sequence, index -
PUBLIC : 모든 유저를 승인/취소
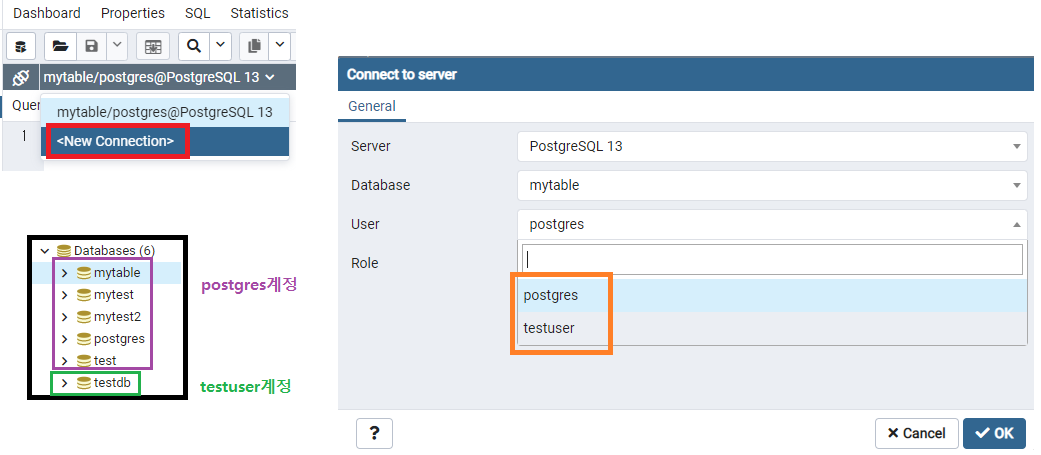
![Untitled]()
💡 다른 계정의 데이터베이스 테이블에 접근했을 때 아래와 같은 오류 출력
1
2
3
4
5
6
| ERROR: 오류: "public.users" 이름의 릴레이션(relation)이 없습니다
LINE 1: select * from public.users;
^
ERROR: 오류: "testtest" 스키마(schema) 없음
LINE 1: create table testtest.testtest(id int);
^
|
아키텍처
![Untitled]()
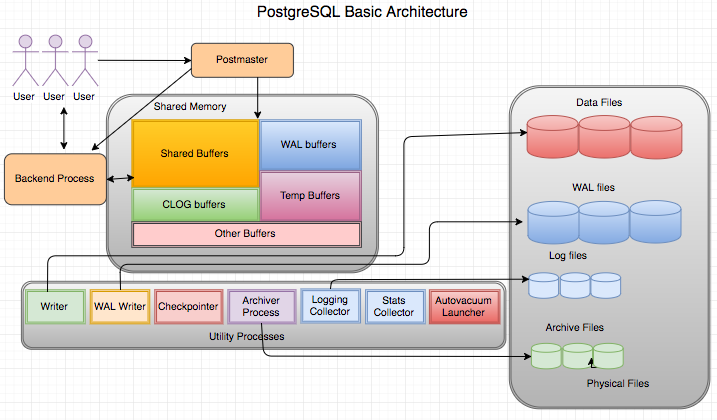
< Postmaster Daemon >
-
postmaster : PostgreSQL 기동할 때 가장 먼저 시작되는 프로세스. 초기 복구 작업, 메모리 초기화, Background 프로세스 기동 작업 수행. 데몬 프로세스로 Client 프로세스의 접속 요청을 받아 Backend 프로세스를 생성.
< Shared Memory >
-
shared buffer : 사용자가 요청한 데이터 블록을 저장하는 공간, 서버 메모리의 1/4 이상 권장됨. -
WAL(Write Ahead Log) buffer : 데이터 변경 사항을 저장하는 버퍼이며, WAL writer 프로세스를 통해 WAL 파일에 기록. -
CLOG buffer : commit log, 트랜잭션 상태를 캐싱하는 메모리 공간으로 트랜잭션이 commit 되었는지 기록함.
< Background Process >
-
Writer : 주기적으로 dirty 버퍼를 데이터 파일에 기록. -
WAL writer : WAL 버퍼를 WAL 파일에 기록한다. -
Checkpointer : 체크 포인트 발생시 dirty 버퍼를 데이터파일에 기록. -
Archiver Process : Archive mode 사용시 WAL 파일을 지정된 디렉토리로 복사한다. -
Loggin Collector : 에러 메시지를 로그 파일에 기록. -
Stats collector : 세션 수행 정보, 테이블 사용 통계 정보 같은 DBMS 통계 정보 수집한다. -
Autovacuum Launcher : MVCC를 위해 update /delete 수행 시 DB에 다중 버전의 레코드를 저장하는데 vacuum 을 통해 더 이상 참조되지 않는 레코드를 정리함, 그 외에도 트랜잭션 ID (XID) 정리 , 테이블 통계작업 등을 수행함. (Vacuum이 필요한 시점에 Postmaster 프로세스에 autovacuum worker 프로세스 기동 요청)
< Backend Process >
-
Backend 프로세스- 최대 개수는 max_connections 파라미터로 설정 가능하며, 기본값은 100.
- 사용자 프로세스의 쿼리 요청을 수행한 후, 결과를 전송하는 역할을 수행.
아키텍처 단순화
![Untitled]()
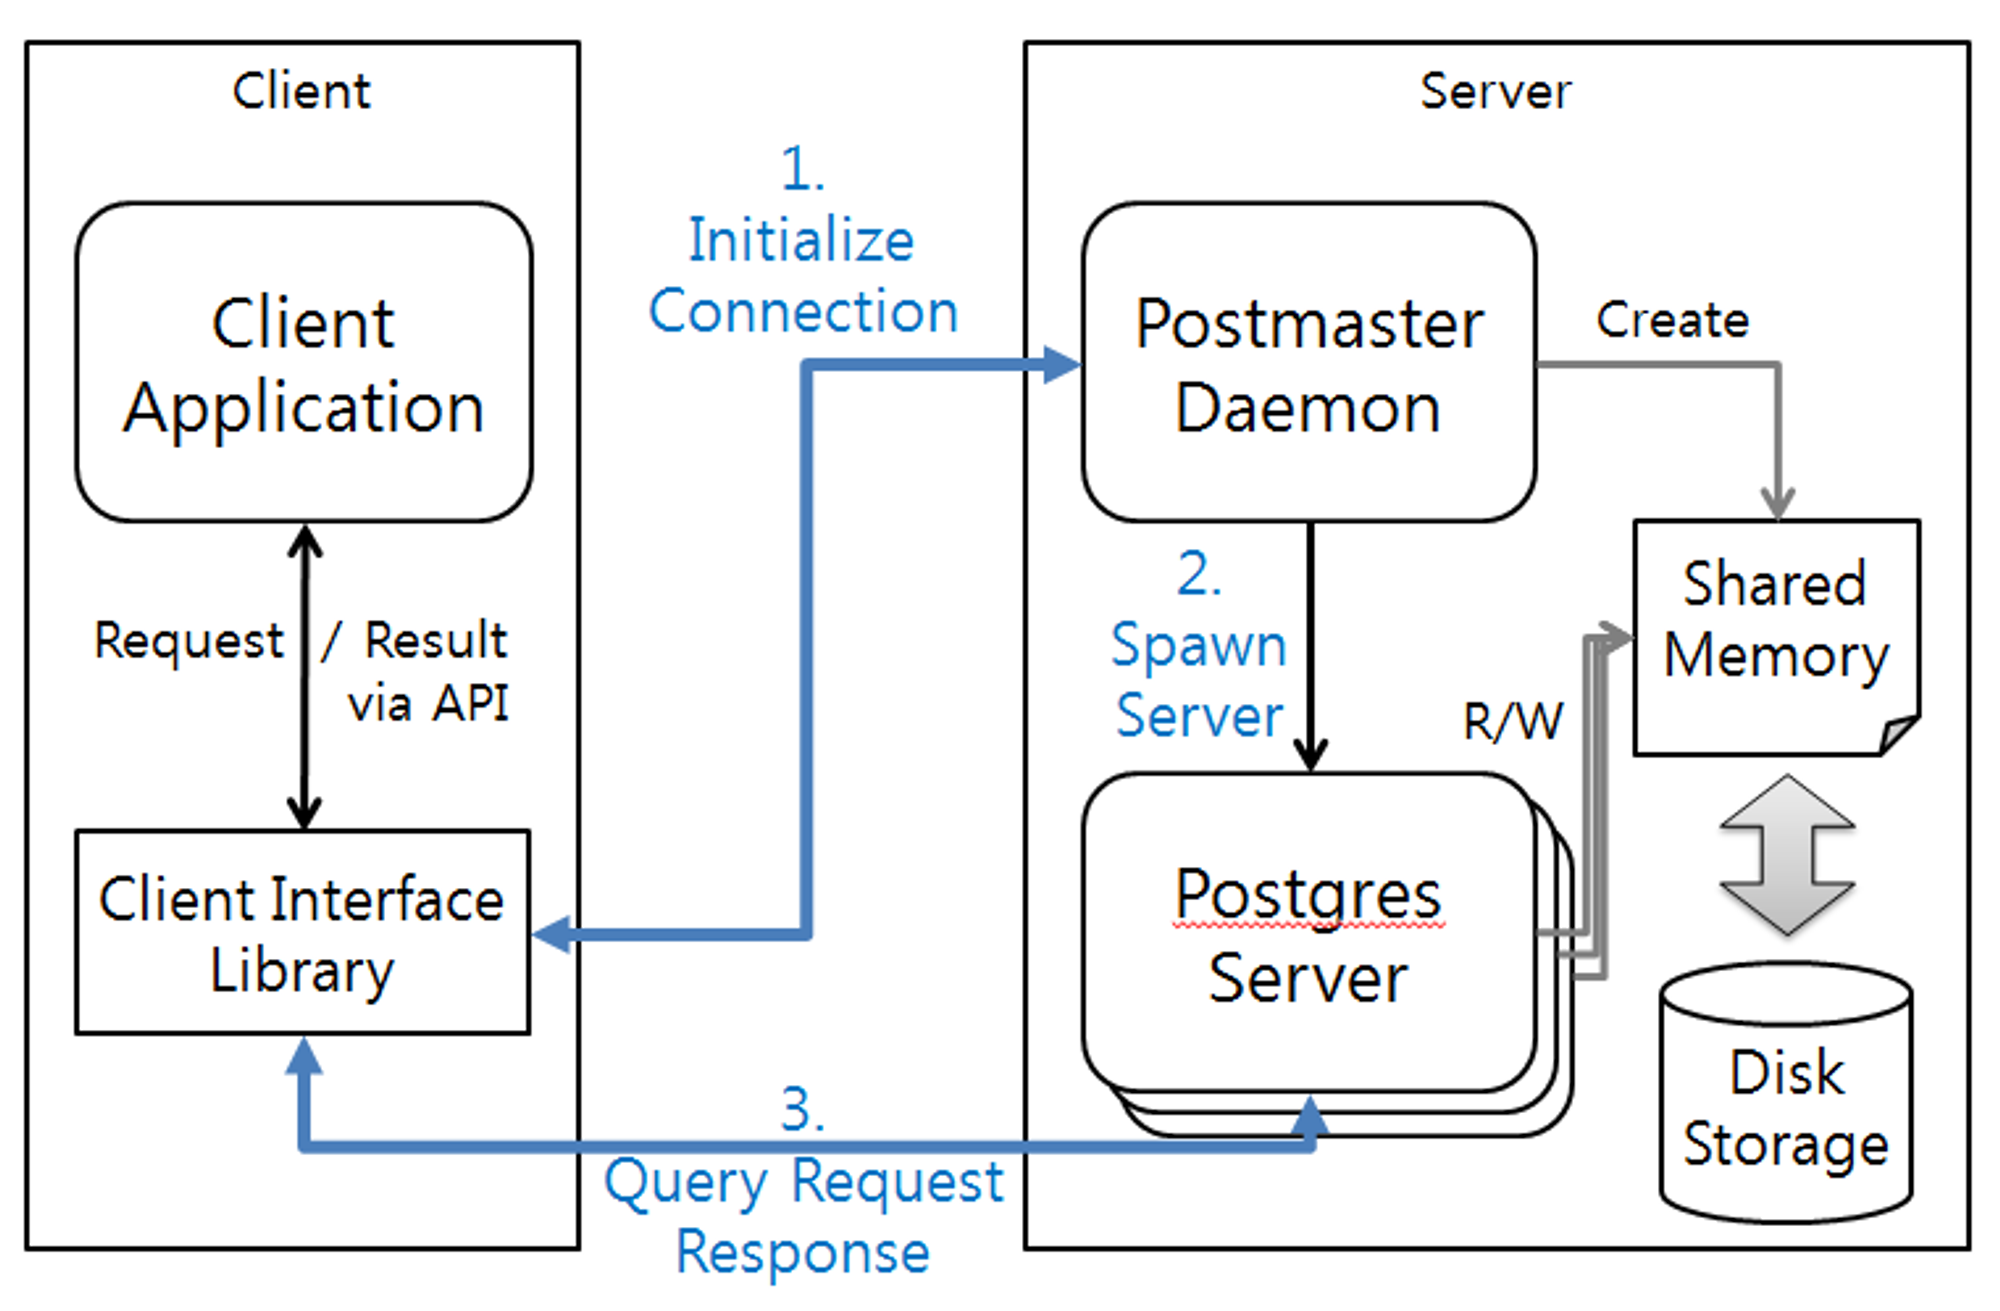
💡 ① 연결 초기화 : 클라이언트에서 인터페이스 라이브러리(JDBC, ODBC 등)을 통해 서버와의 연결 요청
👉 ② 서버 생성 : Postmaster 프로세스가 서버와의 연결을 중계
👉 ③ 쿼리 요청 응답 : 할당된 서버에서 질의를 수행한 후 클라이언트를 통해 응답
5) 세부 기능 및 제한
| 기능 이름 | 뜻 |
|---|
| 🚩 Nested transactions (savepoints) | 중첩된 트랜잭션(저장시점) |
| Point in time recovery | 시점 복구 |
| Online/hot backups, Parallel restore | 온라인/열린 백업, 병렬 복원 |
| 🚩 Rules system (query rewrite system) | 규칙 시스템(쿼리 다시 쓰기 시스템) |
| 🚩 B-tree, R-tree, hash, GiST method indexes | B-트리, R-트리, 해시, GiST 메서드 인덱스 |
| Multi-Version Concurrency Control (MVCC) | 다중 버전 동시 제어(MVCC) |
| 🚩 Tablespace | 테이블스페이스 |
| Procedural Language | 절차 언어 |
| Information Schema | 정보 스키마 |
| I18N(Internationalization), L10N(Localization) | 국제화, 현지화 |
| Database & Column level collation | 데이터베이스 및 열별 데이터 정렬 |
| 🚩 Array, XML, UUID type | - |
| 🚩 Auto-increment (sequences) | 자동 증가(시퀀스) |
| 🚩 Asynchronous Replication | 비동기 복제 |
| 🚩 LIMIT/OFFSET | 제한/오프셋 |
| Full text search | 전체 텍스트 검색 |
| SSL, IPv6 | 인증 |
| Key/Value storage | 키/값 저장 |
| Table inheritance | 테이블상속 |
1. Nested transactions (savepoints): 중첩된 트랜잭션(저장시점)
- 트랜잭션 내에서 또 다른 트랜잭션 정의 가능
- Savepoint를 설정함으로서 유연한 작업 처리 가능
💡 details
- PostgreSQL에서의 트랜잭션 작업 : 작업 앞 뒤로 BEGIN 명령과 COMMIT 명령을 지정
1
2
3
4
5
6
| BEGIN;
// BEGIN과 COMMIT 사이 : 트랜잭션 블록
UPDATE accounts SET balance = balance - 100.00
WHERE name = 'Alice';
-- etc etc
COMMIT;
|
- Savepoint 지정
1
2
3
4
5
6
7
8
9
10
11
12
13
| BEGIN;
UPDATE accounts SET balance = balance - 100.00
WHERE name = 'Alice';
// 세이브 포인트
SAVEPOINT my_savepoint;
UPDATE accounts SET balance = balance + 100.00
WHERE name = 'Bob';
// 롤백
ROLLBACK TO my_savepoint;
// 세이브 포인트를 기준으로 롤백됨으로써, 'Bob'에 대한 update는 취소됨
UPDATE accounts SET balance = balance + 100.00
WHERE name = 'Wally';
COMMIT;
|
2. Rules system (query rewrite system): 규칙 시스템(쿼리 다시 쓰기 시스템)
- 규칙 생성으로 SELECT, INSERT, UPDATE, DELETE 작업에 대한 확장 가능
💡 제대로 작동하지 않기 때문에 거의 사용하지 않는 기능임. 현재는 트리거로 대체됨.
1
2
3
| CREATE [ OR REPLACE ] RULE name AS ON event
TO table_name [ WHERE condition ]
DO [ ALSO | INSTEAD ] { NOTHING | command | ( command ; command ... ) }
|
- name : 규칙 이름
- event : SELECT, INSERT, UPDATE, DELETE중 하나의 작업
- table_name : 규칙을 적용할 테이블 또는 뷰 이름
- condition : SQL 조건부 식(boolean 반환)
- instead : 원래 명령 대신 명령 실행
- also : 원래 명령 외 명령 실행
- command : 규칙 작업을 구성하는 명령. 유효한 명령은 SELECT, INSERT, UPDATE, DELETE 또는 Notify.
1
2
3
4
5
| CREATE VIEW myview AS SELECT * FROM mytab;
CREATE TABLE myview (same column list as mytab);
CREATE RULE "_RETURN" AS ON SELECT TO myview DO INSTEAD
SELECT * FROM mytab;
|
3. B-tree, R-tree, hash, GiST method indexes: B-트리, R-트리, 해시, GiST 메서드 인덱스
- B-트리인덱스 : 데이터를 정렬하여 탐색, 삽입, 삭제 및 순차 접근이 가능하도록 유지하는 트리형 자료구조에 대한 인덱스
- R-트리 : 공간으로 나누어진 데이터에 대한 질의를 빠르게 수행할 수 있는 트리 자료 구조에 대한 인덱스
- 해시 인덱스 : 해시함수를 거쳐 키값이 포함된 버켓을 찾아내는 방식의 인덱스
- GiST 메서드 인덱스 : PostgreSQL에서 제공하는 인덱스. 기하학 데이터, 텍스트 검색 문서 등 여러 가지 인덱스 옵션 설정 가능
💡 참조자료
1
2
3
4
5
6
7
| // 인덱스 생성
CREATE [ UNIQUE ] INDEX [ CONCURRENTLY ] [ [ IF NOT EXISTS ] 이름 ] ON [ ONLY ] 테이블이름 [ USING 색인방법 ]
( { 칼럼이름 | ( 표현식 ) } [ COLLATE 문자정렬규칙 ] [ 연산자클래스 ] [ ASC | DESC ] [ NULLS { FIRST | LAST } ] [, ...] )
[ INCLUDE ( 칼럼이름 [, ...] ) ]
[ WITH ( 저장_매개변수 = 값 [, ... ] ) ]
[ TABLESPACE 테이블스페이스이름 ]
[ WHERE 조건절 ]
|
4. Tablespace: 테이블스페이스
- DB관리자에 의해 데이터베이스의 객체가 저장될 수 있는 파일시스템의 경로
💡 데이터베이스 관리자가 데이터베이스 객체를 나타내는 파일을 저장할 수 있는 파일 시스템의 위치를 정의할 수 있게 하는 것.
데이터베이스 객체가 파일 시스템상에 저장되는 물리적인 공간.
Tablespace를 이용하여 데이터베이스의 목적에 따라 저장소를 다르게 사용하는 운영이 가능해지며, 장애 대응 및 복구 등의 용도로도 활용이 가능.
1
2
3
4
5
| // 새 테이블 스페이스 생성
CREATE TABLESPACE myTableSpace LOCATION '\data\myTableSpace';
// 데이터베이스를 생성하며 테이블 저장소(테이블 스페이스)를 지정
CREATE DATABASE myTable WITH TABLESPACE = myTableSpace;
|
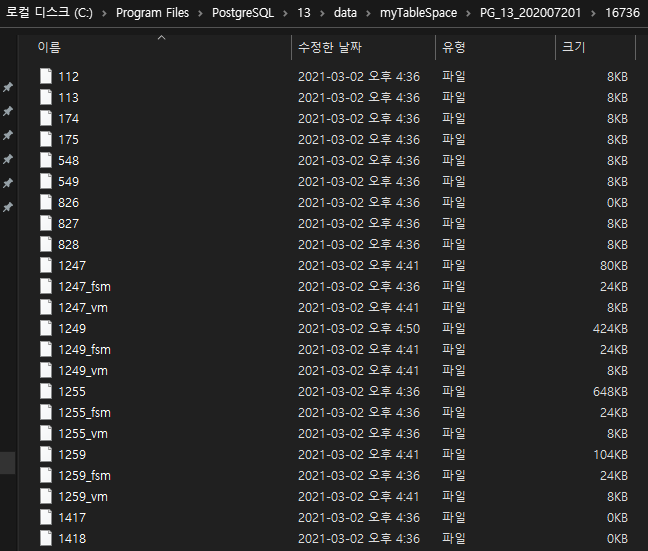
해당 데이터베이스에 테이블을 생성하면 Tablespace의 저장소에 데이터베이스 객체를 나타내는 파일들이 저장됨
![Untitled]()
1
2
3
4
| SELECT
pg_database.dattablespace AS dtspcoid, datname, pg_database.oid,
pg_tablespace.oid AS spcoid, spcname, spcowner
FROM pg_database, pg_tablespace WHERE pg_database.dattablespace = pg_tablespace.oid;
|
| DB_TS | DB 이름 | DB 아이디 | 테이블스페이스 ID | 테이블스페이스 이름 |
|---|
| 1663 | postgres | 13442 | 1663 | pg_default |
| 1663 | test | 16394 | 1663 | pg_default |
| 1663 | template1 | 1 | 1663 | pg_default |
| 1663 | template0 | 13441 | 1663 | pg_default |
| 16735 | mytable | 16736 | 16735 | mytablespace |
| 16746 | mytest | 16747 | 16746 | tbs1 |
| 16748 | mytest2 | 16749 | 16748 | tbs2 |
| 1663 | newuserdb | 16774 | 1663 | pg_default |
| 1663 | testdb | 16757 | 1663 | pg_default |
5. Array, XML, UUID type
💡 ARRAY타입 예시
CREATE
1
2
3
4
5
6
7
| CREATE TABLE member(
id serial PRIMARY KEY,
name varchar(20),
age integer,
hobby varchar(100)[] -- 배열형 컬럼
//테이블을 만들 때 컬럼 타입뒤에 []를 붙이면 배열형 컬럼이 된다.
);
|
INSERT
1
2
| INSERT INTO member (name, age, hobby) VALUES('kim', 10, '{book, music}');
INSERT INTO member (name, age, hobby) VALUES('park', 11, ARRAY['movie','sing','craft']);
|
SELECT
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
| SELECT * FROM member;
// 결과
id | name | age | hobby
----+------+-----+--------------------
1 | kim | 10 | {book,music}
2 | park | 11 | {movie,sing,craft}
(2개 행)
-- 배열형 컬럼의 첫번째 데이터만 읽어 오기
SELECT name, hobby[1] FROM member;
// 결과
name | hobby
------+-------
kim | book
park | movie
(2개 행)
|
6. Auto-increment (sequences): 자동 증가(시퀀스)
- 시퀀스 생성, SERIAL 타입 사용, 기타 구문 사용함으로서 자동 증가 기능 적용 가능
💡 시퀀스 예시
SEQUENCE
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
| -- 시퀀스 생성
CREATE SEQUENCE seq_ttt;
-- 테이블 생성
CREATE TABLE tbl_ttt
(
seq INT NOT NULL default NEXTVAL('seq_ttt') --시퀀스 매칭
, a VARCHAR(10)
);
-- 테이블 삭제시 시퀀스도 같이 삭제 처리
ALTER SEQUENCE seq_ttt OWNED BY tbl_ttt.seq;
-- 삽입
INSERT INTO tbl_ttt (a) VALUES ('aaa');
INSERT INTO tbl_ttt (a) VALUES ('bbb');
INSERT INTO tbl_ttt (a) VALUES ('ccc');
INSERT INTO tbl_ttt (a) VALUES ('ddd');
INSERT INTO tbl_ttt (a) VALUES ('eee');
INSERT INTO tbl_ttt (seq, a) VALUES (default,'eee');
-- 조회
SELECT * FROM tbl_ttt;
// 조회결과
seq | a
-----+-----
1 | aaa
2 | bbb
3 | ccc
4 | ddd
5 | eee
6 | eee
(6개 행)
-- 자동적으로 테이블과 시퀀스가 삭제
DROP TABLE tbl_ttt;
|
SERIAL
1
2
3
4
5
6
7
8
9
10
11
12
13
| // CREATE
CREATE TABLE TEST (
id SERIAL PRIMARY KEY, --PK지정을 해야 자동증가
name VARCHAR NOT NULL
);
// INSERT
INSERT INTO TEST(name) VALUES ('APPLE');
INSERT INTO TEST(id, name) VALUES (default, 'BANANA');
INSERT INTO TEST(id, name) VALUES (1, 'ORANGE');
-- id값을 강제로 입력할 수 있으므로 중복이 발생할 수 있음(PK지정으로 ERROR)
// ERROR: 오류: 중복된 키 값이 "test_pkey" 고유 제약 조건을 위반함
// DETAIL: (id)=(1) 키가 이미 있습니다.
|
GENERATED { ALWAYS | BY DEFAULT } AS IDENTITY
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
| CREATE TABLE foo
(
id INTEGER GENERATED ALWAYS AS IDENTITY,
name VARCHAR
);
INSERT INTO foo (name) VALUES ('가가가');
INSERT INTO foo (id, name) VALUES (default,'나나나');
INSERT INTO foo (name) VALUES ('나나나');
INSERT INTO foo (id, name) VALUES (9,'나나나');
-- 직접 id 필드에 값을 할당할 경우 error 발생
// ERROR: 오류: "id" 칼럼에 자료를 입력할 수 없습니다
// DETAIL: Column "id" is an identity column defined as GENERATED ALWAYS.
// HINT: Use OVERRIDING SYSTEM VALUE to override.
// override system value 사용 시 중복 가능
INSERT INTO foo (id, name) OVERRIDING SYSTEM VALUE VALUES (3,'나나나');
SELECT * FROM foo;
// 조회결과
id | name
----+--------
1 | 가가가
2 | 나나나
3 | 나나나
3 | 나나나
(4개 행)
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
| CREATE TABLE foo1
(
id INTEGER GENERATED BY DEFAULT AS IDENTITY,
name VARCHAR
);
INSERT INTO foo1 (name) VALUES ('가가가');
INSERT INTO foo1 (id,name) VALUES (1,'가가가'); // 중복 가능
INSERT INTO foo1 (id,name) VALUES (default,'홍길동');
SELECT * FROM foo1;
// 조회결과
id | name
----+--------
1 | 가가가
1 | 가가가
2 | 홍길동
(3개 행)
|
7. Asynchronous Replication: 비동기 복제
- Log-Shipping, 스트리밍 복제 방식 제공
💡 출처[공식][공식2][1][PostgreSQL Replication에 대한 보다 더 자세한 글]
1. 복제가 왜 필요한가?
😨 운영 서버가 장애로 멈추게 된다면
→ 😧 대기 서버를 운영해서 가용성을 향상하면 되지 있을까?
→ 🧐 그렇다면 운영 서버의 데이터가 대기 서버와 일치해야 한다
→ 😮 복제가 필요하다!
= warm standby, 또는 log shipping 기능
✔️ 운영 서버와 대기 서버가 모두 실행 중이어야 함.
✔️ 운영 서버는 아카이브 모드로 운영되며, 운영 중에 생기는 다 쓴 WAL 세그먼트 파일(트랜잭션 로그 파일)을 차례대로 대기 서버로 보낸다.
✔️ 대기 서버는 복구 모드 전용으로 실행.
✔️ 이 방식을 이용하면, 데이터베이스 테이블들을 수정할 필요가 없고, 복제 관리가 용이하다.
로그 전달 대기 서버 구현 방식
- 운영 서버에서 다 쓴 WAL 파일을 다른 서버로 운송(shipping) 한다.
- 로그 전달 방식은 비동기식임을 기억한다.
- 다시 말해, WAL 내용은 이미 커밋된 자료이기 때문에, 서버로 전달 되기전에 운영 서버가 멈추면 손실된다. (손실량을 줄이는 방법으로
archive_timeout 설정값을 초단위로 짧게 지정한다) - 대기 서버로 WAL 파일이 제때 잘 넘어오면, 운영 서버가 중지된 후 대기 서버가 그 역할을 맡기까지 서비스가 중지되는 시각은 극히 짧다. 이렇게 가용성을 향상시킨다!
복제 방식의 종류
서버가 대기 모드로 실행되면, 서버는 마스터 서버에서 받는 WAL 파일을 계속해서 자신의 서버에 반영하는 작업만 한다.
🔧 Log-Shipping(Warm standby)
대기 서버가 운영서버에서 보내는 파일을 보관해 두는 디렉토리에 새 WAL 파일이 있는지 확인 후, 새 WAL 파일을 반영하는 방식.
🔧 스트리밍 복제
TCP연결 방식을 이용해서 운영 서버와 직접 연결, 커밋된 트랜잭션을 즉시 대기 서버로 반영하는 방식.
2. 스트리밍 복제
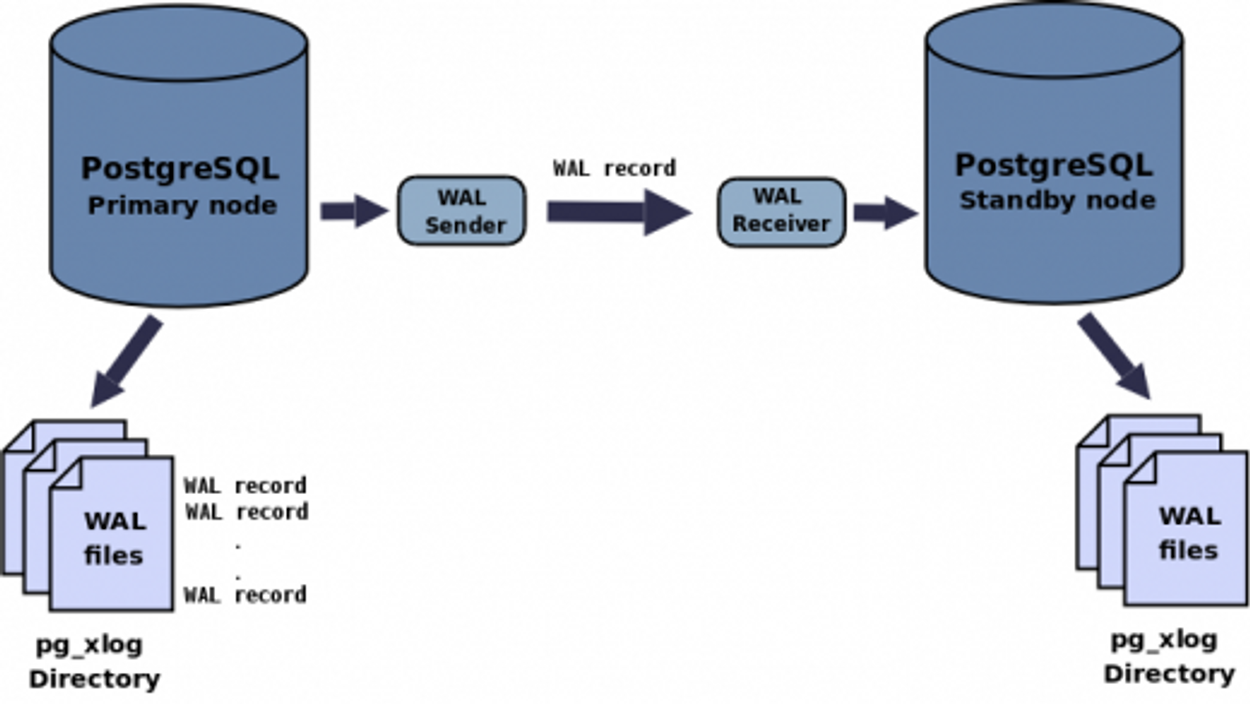
💡 Streaming-Replication : Master 에서 생성된 WAL log를 Slave DB로 실시간성으로 전달하여 정합성을 일치시키는 replication 방법
![Untitled]()
3. PostgreSQL Replication에 대한 보다 더 자세한 글
- 테스트 환경 : CentOS 7.5 , PostgreSQL 10.4 버전
1-1) WAL-Write Ahead Log
- 마스터 서버에서 발생하는 모든 작업 로그를 생성
- 생성된 로그를 스탠바이 서버로 전달
- 스탠바이 서버에서 받은 로그의 복원(재실행)
💡 위와 같은 동작으로 마스터 서버와 같은 스키마를 가진 복제 서버를 생성합니다.
– 마스터 서버의 로그를 WAL 이라고 하며, $설치경로/data/pg_xlog 에 쌓이게 됩니다.
– 메뉴얼의 설치 경로는 /usr/local/pgsql/data 입니다.
1-2) WAL 전달 방식
< Log-Shipping 방식 >
- pg_xlog 안에 WAL 파일 자체를 스탠바이 서버로 전달
- 마스터 서버에서 저장된 WAL 파일의 크기를 지정된 사이즈 만큼 채워야 스탠바이 서버로 전송
- 채워지는 시간동안 마스터/스탠바이 서버간의 데이터가 어긋남
- 마스터 서버 장애 발생 시, WAL 파일을 다 채우지 못하여 전달되지 않을 경우 데이터 유실 있음
< Streaming 방식 > * PostgreSQL 9.0 이상 버전에서 사용 가능
- WAL 파일 저장 여부와 관계없이 로그내용을 스탠바이 서버로 전달
- 서버 간의 네트워크 문제가 없다는 가정하에, 거의 실시간으로 작동
- 스탠바이 서버의 장애가 발생 시, 유실된 데이터 복구를 위해서는 스탠바이 서버를 처음부터 다시 구축해야 함
= Streaming 방식을 사용하더라도, Log-shipping 방식을 적용해 놓는 것이 좋음
2. Streaming Replication 적용
- 마스터와 스탠바이 2대의 서버가 존재하는 상태에서 진행
- 실행 계정은 설치 계정인 postgres
2-1) 마스터 서버 설정
- Streaming 방식 적용을 위해 스탠바이 서버에서 마스터 서버에 접근할Replication 전용 유저를 생성
1
| # postgres= create role repluser with replication password ‘password’ login;
|
- 생성한 계정의 접근 권한 설정
1
2
| # vim /usr/local/pgsql/data/pg_hba.conf
host replication repluser [스탠바이 서버 ip]/32 trust
|
- 복제를 위한 설정
1
2
3
4
5
| # vim /usr/local/pgsql/data/postgresql.conf
listen_addresses = ‘*’ # 인증/권한 관리는 pg_hba.conf 파일에서 설정
wal_level = hot_standby # 대기 서버에 읽기전용 작업 가능 설정
max_wal=senders = 2 # WAL 파일을 전송할 수 있는 최대 서버 수
wal_keep_segments = 32 # 마스터 서버 디렉토리에 보관할 최근 WAL 파일 수
|
2-2) 스탠바이 서버 설정
-
pg_basebackup 명령어를 통해 최초 백업을 진행해야 합니다. - 마스터 서버의
/usr/local/pgsql/data 디렉토리 전체를 스탠바이 서버로 복제/복원을 합니다. - 스탠바이 서버 해당 경로의 모든 파일을 덮어쓰기 때문에,
postgresql.conf 파일을 미리 백업해두는 것이 좋습니다. - 복제/복원 후 백업한
postgresql.conf 파일을 복구합니다. -
/usr/local/pgsql/data 디렉토리는 비워있어야 복제/복원이 진행 가능합니다.1
2
| # pg_basebackup -h [마스터 서버 ip] -D /usr/local/pgsql/data
-U repluser -v -P –wal-method=stream
|
- WAL 내용을 Streaming 방식으로 설정
1
2
3
| # vim /usr/local/pgsql/data/postgresql.conf
listen_addresses = ‘*’
hot_standby = on # 대기 서버에 읽기전용 작업 가능 설정
|
- 추가로
postgresql.conf 파일과 같은 경로에 recovery.conf 파일을 생성 -
primary_conninfo 옵션의 정보로 마스터 서버에 접속해 실시간으로 WAL 내용을 전달 받습니다.1
2
3
4
| # vim /usr/local/pgsql/data/recovery.conf
standby_mode = on
primary_conninfo = ‘host=[마스터 서버 ip] port=5432
user=repluser password=password’
|
2-3) 설정 확인
- 마스터 서버와 스탠바이 서버 설정이 완료 후 마스터 서버와 스탠바이 서버 차례로 데몬을 실행해 줍니다.
[마스터서버 실행 상태]
1
2
3
4
5
6
7
8
9
10
| # ps -ef |grep postgres
postgres 596 32676 0 05:46 ? 00:00:00 postgres: wal sender process repluser 115.68.x.x(56100) streaming 0/3000140
postgres 32676 1 0 04:36 ? 00:00:00 /usr/local/pgsql/bin/postgres -i -D /usr/local/pgsql/data
postgres 32678 32676 0 04:36 ? 00:00:00 postgres: checkpointer process
postgres 32679 32676 0 04:36 ? 00:00:00 postgres: writer process
postgres 32680 32676 0 04:36 ? 00:00:00 postgres: wal writer process
postgres 32681 32676 0 04:36 ? 00:00:00 postgres: autovacuum launcher process
postgres 32682 32676 0 04:36 ? 00:00:00 postgres: stats collector process
postgres 32683 32676 0 04:36 ? 00:00:00 postgres: bgworker: logical replication launcher
// 정상적으로 리플리케이션 설정이 되었다면 위의 굵은 글씨의 wal sender process를 확인할 수 있습니다.
|
- 마스터 서버에서 아래와 같은 쿼리를 실행하면 더 확실하게 확인이 가능합니다.
1
2
3
4
5
6
7
8
| # ps -ef |grep postgres
postgres 17151 1 0 05:39 ? 00:00:00 postmaster -p 5432 -D /usr/local/pgsql/data
postgres 17152 17151 0 05:39 ? 00:00:00 postgres: startup process recovering 000000010000000000000003
postgres 17153 17151 0 05:39 ? 00:00:00 postgres: checkpointer process
postgres 17154 17151 0 05:39 ? 00:00:00 postgres: writer process
postgres 17155 17151 0 05:39 ? 00:00:00 postgres: stats collector process
postgres 17156 17151 0 05:39 ? 00:00:07 postgres: wal receiver process streaming 0/3000140
// 정상적으로 리플케이션 설정이 되었다면 마스터 서버의 wal sender process에서 보내고 있는 키(0/3000140)와 같은 키를 받고 있는 것을 확인할 수 > 있습니다.
|
3. Log-Shipping Replication 적용
- 혹시 모를 스탠바이 서버의 장애를 대비하기 위해 Log-Shipping 방식을 함께 적용할 수 있습니다.
- 스탠바이 서버의 WAL 복원자체는 Streaming 방식으로 하고, WAL 파일을 저장하게 됩니다.
3-1) WAL 파일을 저장할 디렉토리 설정 * 스탠바이 서버에서 설정
- 반드시 스탠바이 서버에 저장할 필요는 없으며, 스탠바이 서버가 접근 가능한 위치면 됩니다.
- 본 메뉴얼에서는 스탠바이 서버 postgres 계정의 홈 디렉토리(/usr/local/pgsql)에 저장을 하였습니다.
1
2
3
| # mkdir /usr/local/pgsql/archives
# chown postgres:postgres /usr/local/pgsql/archives
# chmod 700 /usr/local/pgsql/archives
|
3-2) 비밀번호 없이 scp 동작하도록 설정 * 마스터 서버에서 설정
- 자동화를 위해 마스터서버로 ssh 접속 시 비밀번호 입력을 안해도 되도록 설정을 해줍니다.
1
2
| # sudo -u postgres ssh-keygen
# sudo -u postgres ssh-copy-id -i /usr/local/pgsql/.ssh/id_rsa.pub postgres@[스탠바이 서버 ip]
|
- WAL 파일 전송 설정
1
2
3
| # vim /usr/local/pgsql/data/postgresql.conf
archive_command = ‘scp -i /usr/local/pgsql/.ssh/id_rsa %p postgres@[스탠바이 서버 ip]:/usr/local/pgsql/archives/%f’
archive_timeout = 30
|
- %p는 archive(WAL) 파일의 full path 이고, %f는 파일의 이름입니다.
3-3) 설정 확인
- 마스터 서버를 재시작하면, 스탠바이 서버의 지정된 디렉토리에 파일이 쌓이는 것을 확인할 수 있습니다.
1
2
3
4
5
6
7
8
| # ll /usr/local/pgsql/archives/
합계 98304
-rw——- 1 postgres postgres 16777216 8월 13 01:55 000000010000000000000004
-rw——- 1 postgres postgres 16777216 8월 13 02:00 000000010000000000000005
-rw——- 1 postgres postgres 16777216 8월 13 02:02 000000010000000000000006
-rw——- 1 postgres postgres 16777216 8월 13 02:21 000000010000000000000008
-rw——- 1 postgres postgres 16777216 8월 13 09:09 000000010000000000000009
-rw——- 1 postgres postgres 16777216 8월 13 09:14 00000001000000000000000A
|
PostgreSQL 실행 스크립트
- PostgreSQL을 소스설치를 하는 경우, pg_ctl 명령어로 데몬 실행을 해야 합니다.
- PostgreSQL은 보안적인 이유로 root 권한으로 데몬의 실행을 허가하지 않습니다.
- 이런 이유로 인해 반드시 일반유저로 로그인해서 실행해야 하는데, 일반적으로 postgres라는 계정으로 실행하게 됩니다.
- 아래는 소스설치를 하는 경우, root에서 데몬 실행을 위한 스크립트파일 내용입니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
| # vim /etc/init.d/postgresql
#!/bin/sh
# PostgreSQL START/STOP/RESTART Script
SERVER=/usr/local/pgsql/bin/postmaster
PGCTL=/usr/local/pgsql/bin/pg_ctl
PGDATA=/usr/local/pgsql/data
OPTIONS=-i
LOGFILE=/usr/local/pgsql/data/postmaster.log
case “$1” in
start)
echo -e “Starting PostgreSQL…”
su -l postgres -c “nohup $SERVER $OPTIONS -D $PGDATA >> $LOGFILE 2>&1 &”
;;
stop)
echo -e “Stopping PostgreSQL…”
su -l postgres -c “$PGCTL -D $PGDATA stop”
;;
restart)
echo -e “Stopping PostgreSQL…”
su -l postgres -c “$PGCTL -D $PGDATA stop”
echo -e “Starting PostgreSQL…”
su -l postgres -c “nohup $SERVER $OPTIONS -D $PGDATA >> $LOGFILE 2>&1 &”
;;
*)
echo -e “Usage: $0 { start | stop | restart }”
exit 1
;;
esac
exit 0
|
8. LIMIT/OFFSET: 제한/오프셋
- Pagination을 간편하게 구현할 수 있도록 함
1
2
3
4
5
6
| -- 처음 10개의 Row를 반환
SELECT * FROM test LIMIT 10;
SELECT * FROM test LIMIT 10 OFFSET 0;
-- 11번째부터 10개의 ROW를 반환
SELECT * FROM test LIMIT 10 OFFSET 10;
|
9. SSL, IPv6: 인증
- 데이터베이스 클러스터 내 저장된 환경설정 파일인 pg_hba.conf의 각 레코드에서 연결에 사용되는 연결 유형, 클라이언트 IP 주소 범위(연결 유형에 해당하는 경우), 데이터베이스 이름, 사용자 이름 및 인증 방법을 지정
💡 pg_hba.conf 레코드와 필드 상세 내용
1
2
3
4
5
6
7
| local database user auth-method [auth-options]
host database user address auth-method [auth-options]
hostssl database user address auth-method [auth-options]
hostnossl database user address auth-method [auth-options]
host database user IP-address IP-mask auth-method [auth-options]
hostssl database user IP-address IP-mask auth-method [auth-options]
hostnossl database user IP-address IP-mask auth-method [auth-options]
|
10. Key/Value storage: 키/값 저장
- PostgreSQL 내에 키/값 쌍의 집합을 저장하기 위해 hstore라는 모듈 제공
💡 상세정보[1][2]
1
| CREATE EXTENSION hstore; // hstore 활성화
|
1
2
3
4
5
| k => v // => 기호 주변의 공백은 무시
foo => bar, baz => whatever
"1-a" => "anything at all"
// 공백, 쉼표, = 또는 >를 포함하는 두 개의 따옴표로 묶은 키 및 값
// 키 또는 값에 큰따옴표 또는 백슬래시를 포함하려면 백슬래시를 사용
|
1
2
3
4
5
| SELECT 'a=>1,a=>2'::hstore;
// 결과
hstore
----------
"a"=>"1" // 중복 불가
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
| -- 테이블에 적용
CREATE TABLE AddressBook (
id SERIAL PRIMARY KEY,
name VARCHAR,
attributes HSTORE
);
-- 레코드 삽입
INSERT INTO AddressBook (name, attributes) VALUES (
'김가가',
'age => 38,
telephone => "010-1111-1111",
email => "111@aaa.co.kr"'
);
INSERT INTO AddressBook (name, attributes) VALUES (
'김나나',
'age => 29,
telephone => "N/A",
email => "222@bbb.co.kr"'
);
-- 조회
SELECT * FROM AddressBook;
// 결과
id | name | attributes
----+--------+---------------------------------------------------------------------
1 | 김가가 | "age"=>"38", "email"=>"111@aaa.co.kr", "telephone"=>"010-1111-1111"
2 | 김나나 | "age"=>"29", "email"=>"222@bbb.co.kr", "telephone"=>"N/A"
(2개 행)
-- telephone이 'N/A'인 사람 조회
SELECT * FROM AddressBook WHERE attributes->'telephone' = 'N/A';
// 결과
id | name | attributes
----+--------+-----------------------------------------------------------
2 | 김나나 | "age"=>"29", "email"=>"222@bbb.co.kr", "telephone"=>"N/A"
(1개 행)
|
11. Table inheritance: 테이블상속
- 테이블 생성 시 상속 기능 제공
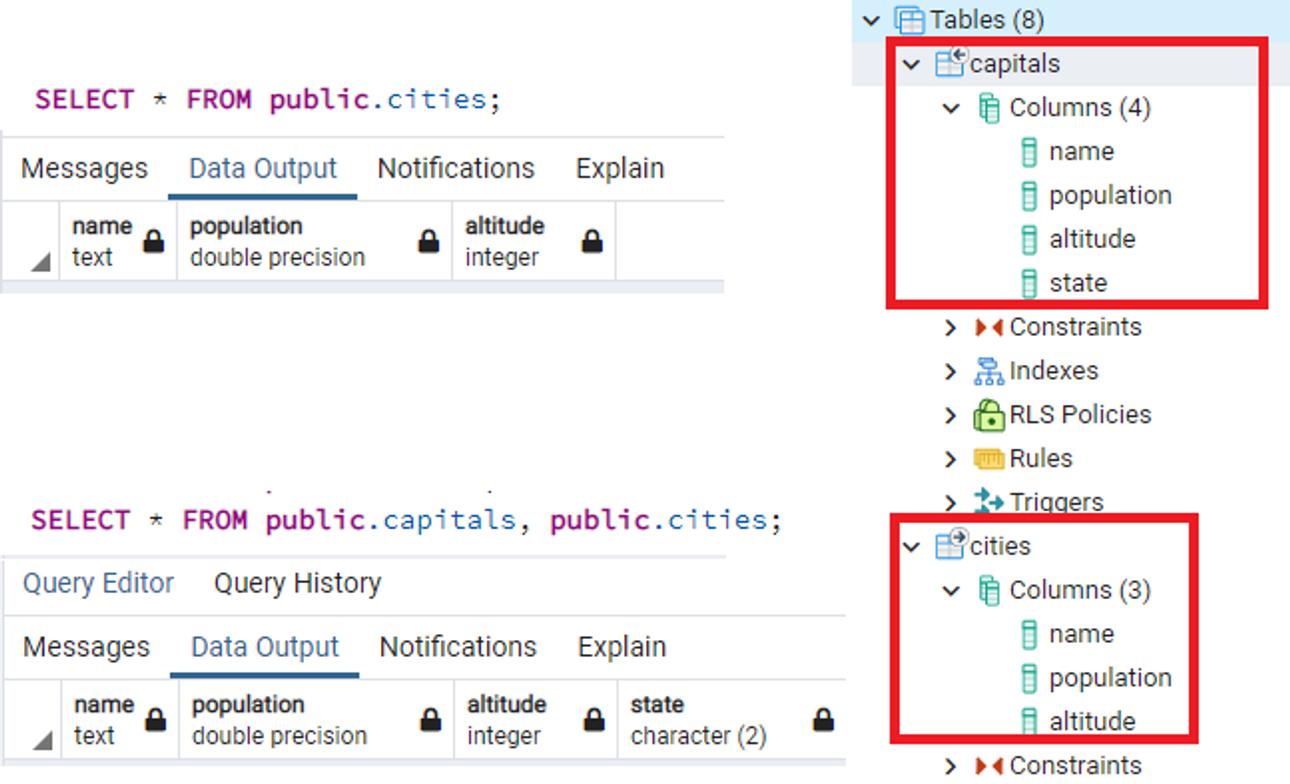
- 상속받은 테이블은 자식테이블, 상속대상 테이블은 부모테이블
💡 상세정보[1][2]
1
2
3
4
5
6
| // 부모 테이블
CREATE TABLE cities (
name TEXT,
population FLOAT,
altitude INT
);
|
1
2
3
4
| // 자식 테이블
CREATE TABLE capitals(
state char(2)
) INHERITS (cities);
|
![Untitled]()
1
2
3
4
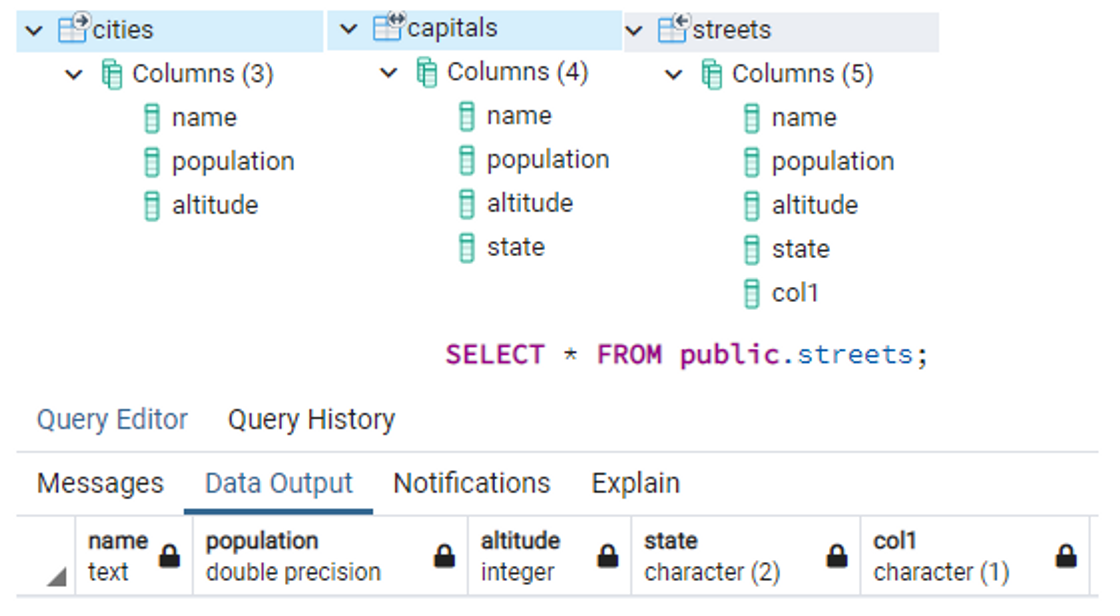
| // 자식테이블 capitals를 상속받는 또 다른 테이블 생성
CREATE TABLE streets (
col1 char(1)
) INHERITS (capitals);
|
![Untitled]()
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
| -- 부모 테이블 삭제 시
DROP TABLE public.cities;
// 아래와 같은 오류가 뜸
ERROR: 오류: 기타 다른 개체들이 이 개체에 의존하고 있어, cities 테이블 삭제할 수 없음
DETAIL: capitals 테이블 의존대상: cities 테이블
streets 테이블 의존대상: capitals 테이블
HINT: 이 개체와 관계된 모든 개체들을 함께 삭제하려면 DROP ... CASCADE 명령을 사용하십시오
SQL state: 2BP01
-- CASCADE 사용
DROP TABLE public.cities CASCADE;
// 결과
알림: 2개의 다른 개체에 대한 관련 항목 삭제
DETAIL: capitals 테이블 개체가 덩달아 삭제됨
streets 테이블 개체가 덩달아 삭제됨
DROP TABLE
-- 삭제 후 조회
SELECT * FROM public.cities;
SELECT * FROM public.capitals;
SELECT * FROM public.streets;
// 결과
ERROR: 오류: "public.streets" 이름의 릴레이션(relation)이 없습니다
LINE 2: SELECT * FROM public.streets; // 나머지 테이블 동일
^
|
제한사항
| 최대 DB 크기(Database Size) | 무제한 |
|---|
| 최대 테이블 크기(Table Size) | 32TB |
| 최대 레코드 크기(Row Size) | 1.6TB |
| 최대 컬럼 크기(Field Size) | 1 GB |
| 테이블당 최대 레코드 개수(Rows per Table) | 무제한 |
| 테이블당 최대 컬럼 개수(Columns per Table) | 250~1600개 |
| 테이블당 최대 인덱스 개수(Indexes per Table) | 무제한 |
6) 경쟁 제품들과의 비교
Oracle
- 오랫동안 검증된 방대한 양의 코드
- 다양한 레퍼런스
- 비싼 비용이 단점
DB2(IBM), MS SQL
MySQL
- 다양한 응용과 레퍼런스
- 기업형 개발 모델과 라이선스 부담(상용시 가격↑)
PostgreSQL
- Postgres Plus Advanced Server 제품의 출시 등으로 엔터프라이즈 DBMS 시장에서 입지 강화 중
- 대용량, 복잡한 트랜잭션 처리에 용이
- 다양한 기능을 사용할 수 있으면서도 상대적으로 적은 비용이 장점
- 교육(메뉴얼), 컨설팅, 마이그레이션, 기술 지원 등 서비스 제공